

248
Hydrologie qu antit ative
l'alea originel, mais prefere un pari, fut- il subjectif, sur les vraies valeurs des
par am etres. Les erre urs sur les sort ies const it uent une information utile pour
est imer cette distribution. C'est I'approche bayesienn e du calage des mod eles.
Cet te approche est presentee en detail en annexo 5.5.
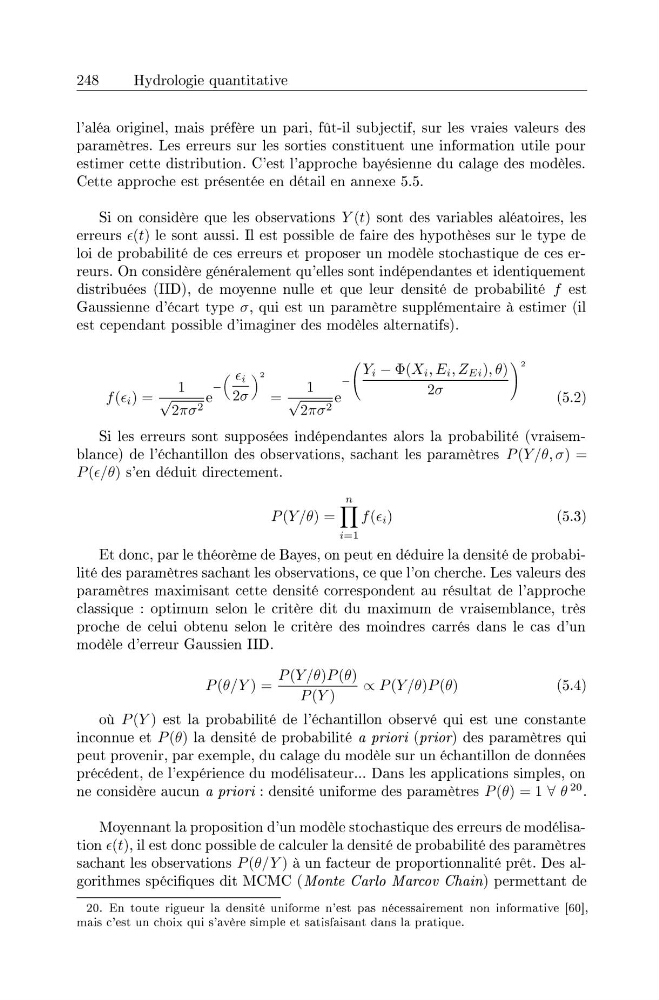
Si on considere que les observations Y(t ) sont des variabl es aleat oires, les
erreurs E(t ) Ie sont au ssi. II est possible de faire des hypotheses sur Ie typ e de
loi de probabilite de ces erreurs et proposer un mod ele st ochas t ique de ces erreurs. On considere general ement qu 'elles sont ind ep end ant es et identiquement
dist ribuees (lID) , de moyenn e nulle et que leur densite de probabilite f est
Gau ssienn e d 'ecart ty pe a , qu i est un par am etre supplementaire a estimer (il
est cependa nt possible d 'im agin er des mod eles alte rnatifs).
Si les erreurs sont supposees ind epend antes alors la probabilite (vraisemblan ce) de l'echantillon des observations, sacha nt les parametres P (Y j B,a ) =
P( EjB) s'e n dedui t directement .
n
P (YjB) = II f( Ei)
i = 1
(5.3)
Et don e, par Ie theorerne de Bayes, on peut en deduire la densite de probabilit e des par am etres sacha nt les observations, ce que I'on cherche. Les valeurs des
paramet res maximisan t cet te densite correspondent au result at de I'approche
c1assique : op timum selon Ie critere dit du maxi mum de vraisembl an ce, tres
proche de celui obtenu selon Ie critere des moindres cartes dan s Ie cas d 'un
modele d 'erreur Gau ssien IID.
P (B jY ) = P (YjB)P(B) P (YjB)P (B)
P (Y)
ex
(5.4)
ou P (Y) est la probabilite de l'echantillon observe qui est un e constante
inconnue et P (B) la densit e de probabili t e a priori (prio r) des parametres qui
peut provenir, par exemple, du calage du mod ele sur un echa nt illon de donnees
precedent , de l'exp erience du mod elisateur... Dan s les applications simples, on
ne considere au cun a prio ri : densi te uni form e des param etres P( B) = 1 'V B20.
Moyenn ant la proposition d 'un modele st ochas t ique des erreurs de mod elisat ion E(t ), il est don e possible de calculer la densit e de probabilite des par am etres
sacha nt les observations P( Bj Y ) a un facte ur de prop ort ionnalit e pret . Des algorithmes specifiques dit MCM C (Monte Carlo Ma rcou Ch ain) perm et t an t de
20. En to ute rigueur la densite uniforme n 'est pas necessairement non informative [60],
m ais c' est un cho ix qu i s'avere simple et satisfaisa nt dan s la pratique.