

430
Partie 3 • Autres méthodes
Si le nombre de mesures n’est pas très grand, il est important de connaître leur distribution. La courbe obtenue informe sur la fiabilité Re des résultats (du terme anglais reliability). La fiabilité d’une moyenne en tant que moyen d’estimation de la valeur vraie croît
comme la racine carrée du nombre n de mesures.
Re = K
√
n
(22.12)
C’est pourquoi, si on passe de n 1 mesures à un nombre supérieur n 2 , on améliore la fiabilité
Re d’un facteur k tel que :
k =
n 2
n 1
(22.13)
fréquence
2
3
1
valeurs expérimentales
2 1 0 1
valeurs mesurées
f(x)
µ(2)
µ(1)
s
s
2
y
x
2σ
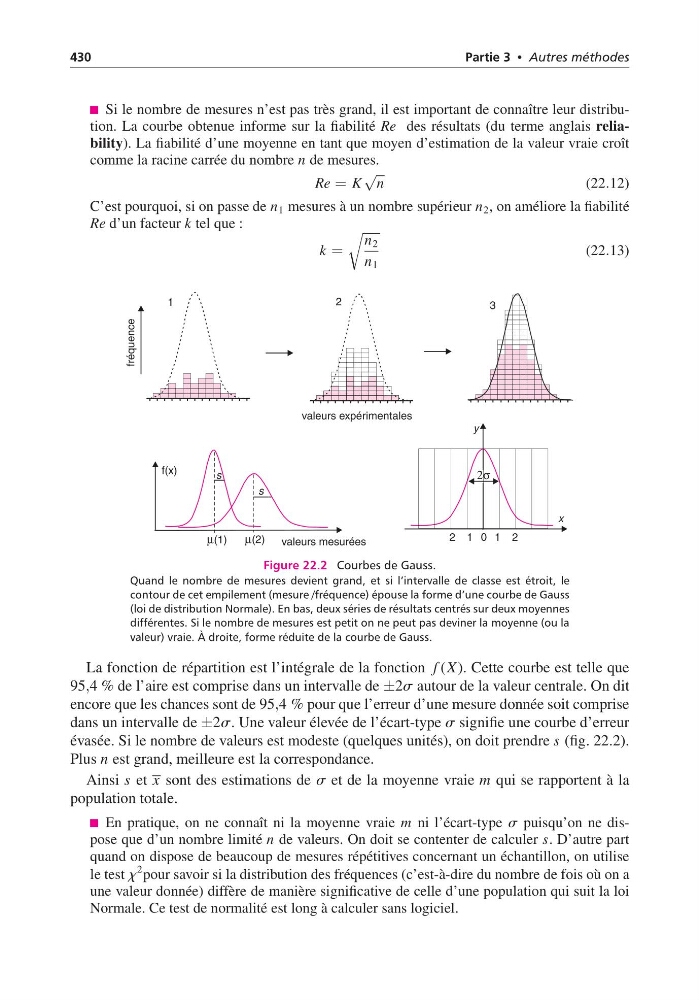
Figure 22.2 Courbes de Gauss.
Quand le nombre de mesures devient grand, et si l’intervalle de classe est étroit, le
contour de cet empilement (mesure /fréquence) épouse la forme d’une courbe de Gauss
(loi de distribution Normale). En bas, deux séries de résultats centrés sur deux moyennes
différentes. Si le nombre de mesures est petit on ne peut pas deviner la moyenne (ou la
valeur) vraie. À droite, forme réduite de la courbe de Gauss.
La fonction de répartition est l’intégrale de la fonction f (X ). Cette courbe est telle que
95,4 % de l’aire est comprise dans un intervalle de ±2s autour de la valeur centrale. On dit
encore que les chances sont de 95,4 % pour que l’erreur d’une mesure donnée soit comprise
dans un intervalle de ±2s. Une valeur élevée de l’écart-type s signifie une courbe d’erreur
évasée. Si le nombre de valeurs est modeste (quelques unités), on doit prendre s (fig. 22.2).
Plus n est grand, meilleure est la correspondance.
Ainsi s et x sont des estimations de s et de la moyenne vraie m qui se rapportent à la
population totale.
En pratique, on ne connaît ni la moyenne vraie m ni l’écart-type s puisqu’on ne dispose que d’un nombre limité n de valeurs. On doit se contenter de calculer s. D’autre part
quand on dispose de beaucoup de mesures répétitives concernant un échantillon, on utilise
le test x
2 pour savoir si la distribution des fréquences (c’est-à-dire du nombre de fois où on a
une valeur donnée) diffère de manière significative de celle d’une population qui suit la loi
Normale. Ce test de normalité est long à calculer sans logiciel.