

153
6.1 Principes de l’indexation
Ici, l’exemple donne un plan d’exécution peu optimal. En effet, la boucle imbriquée implique de faire une lecture par occurrence dans le parcours de l’index,
donc de lire chaque fois une page. Mais, notre petite table tient tout entière dans
une page de données. Donc, au lieu de lire une page, puis de trier, SQL Server fait
dix lectures. À ce volume de données, ce n’est pas important, et SQL Server choisit un plan d’exécution « acceptable ». Si la cardinalité de la table est plus importante, l’optimiseur fera le choix d’un scan, même en présence de l’index.
Supprimons cet index, et créons à la place, un index clustered :
DROP INDEX nix$dbo_indexdemo$id
ON dbo.indexdemo;
GO
CREATE CLUSTERED INDEX cix$dbo_indexdemo$id
ON dbo.indexdemo (id ASC);
GO
que donne un simple
SELECT * FROM dbo.indexdemo;
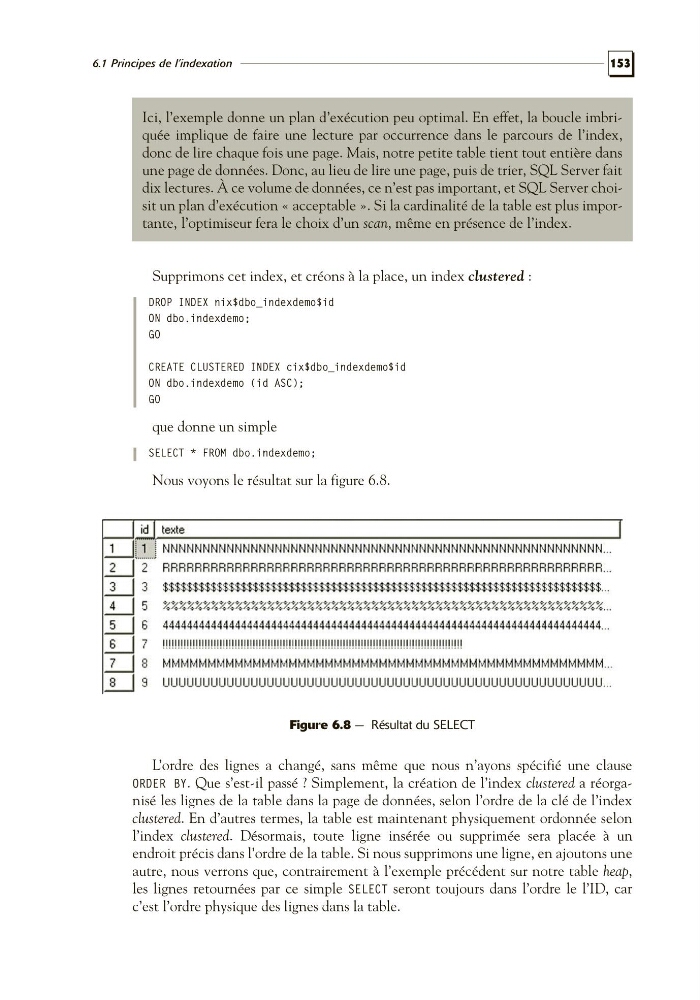
Nous voyons le résultat sur la figure 6.8.
Figure 6.8 — Résultat du SELECT
L’ordre des lignes a changé, sans même que nous n’ayons spécifié une clause
ORDER BY. Que s’est-il passé ? Simplement, la création de l’index clustered a réorganisé les lignes de la table dans la page de données, selon l’ordre de la clé de l’index
clustered. En d’autres termes, la table est maintenant physiquement ordonnée selon
l’index clustered. Désormais, toute ligne insérée ou supprimée sera placée à un
endroit précis dans l’ordre de la table. Si nous supprimons une ligne, en ajoutons une
autre, nous verrons que, contrairement à l’exemple précédent sur notre table heap,
les lignes retournées par ce simple SELECT seront toujours dans l’ordre le l’ID, car
c’est l’ordre physique des lignes dans la table.