

154
Chapitre 6. Utilisation des index
Attention – Ce comportement ne vous dédouane pas de spécifier la clause ORDER
BY si vous souhaitez récupérer un jeu de résultat dans un tri précis. Vous n’avez
aucune garantie que l’ordre des lignes sera consistant, même s’il existe un index
clustered. Dans certains opérateurs de requête (les UNION, les jointures par exemple), SQL Server peut choisir de pré-trier un résultat intermédiaire pour rendre
les opérations suivantes plus rapides. De même, le moteur de stockage peut retourner les pages dans un ordre favorable aux performances plutôt que dans leur ordre
« logique ».
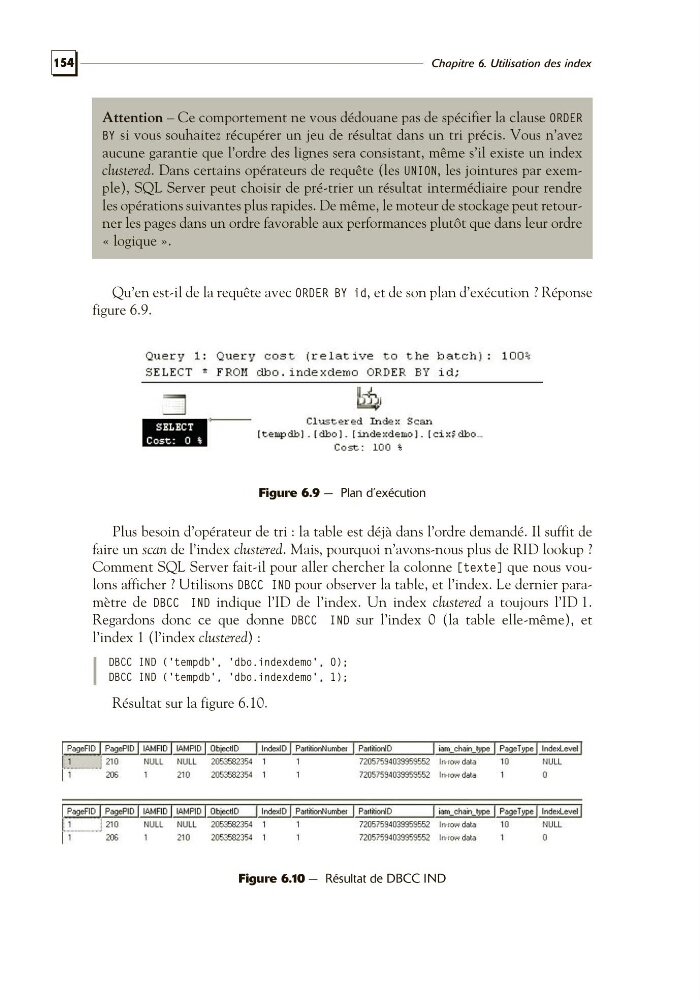
Qu’en est-il de la requête avec ORDER BY id, et de son plan d’exécution ? Réponse
figure 6.9.
Figure 6.9 — Plan d’exécution
Plus besoin d’opérateur de tri : la table est déjà dans l’ordre demandé. Il suffit de
faire un scan de l’index clustered. Mais, pourquoi n’avons-nous plus de RID lookup ?
Comment SQL Server fait-il pour aller chercher la colonne [texte] que nous voulons afficher ? Utilisons DBCC IND pour observer la table, et l’index. Le dernier paramètre de DBCC IND indique l’ID de l’index. Un index clustered a toujours l’ID 1.
Regardons donc ce que donne DBCC IND sur l’index 0 (la table elle-même), et
l’index 1 (l’index clustered) :
DBCC IND ('tempdb', 'dbo.indexdemo', 0);
DBCC IND ('tempdb', 'dbo.indexdemo', 1);
Résultat sur la figure 6.10.
Figure 6.10 — Résultat de DBCC IND