

152
Chapitre 6. Utilisation des index
Vous voyez que la ligne portant l’ID 9 est insérée à la place de la ligne supprimée.
La suppression a libéré 104 octets dans la page, une insertion de la même taille s’est
faite dans l’espace laissé libre. Cela permet de remplir la page. Une table heap n’est
vraiment organisée selon aucun ordre logique ou physique. Si nous voulons obtenir
un résultat ordonné, nous devons le spécifier dans la requête :
SELECT * FROM dbo.indexdemo ORDER BY id;
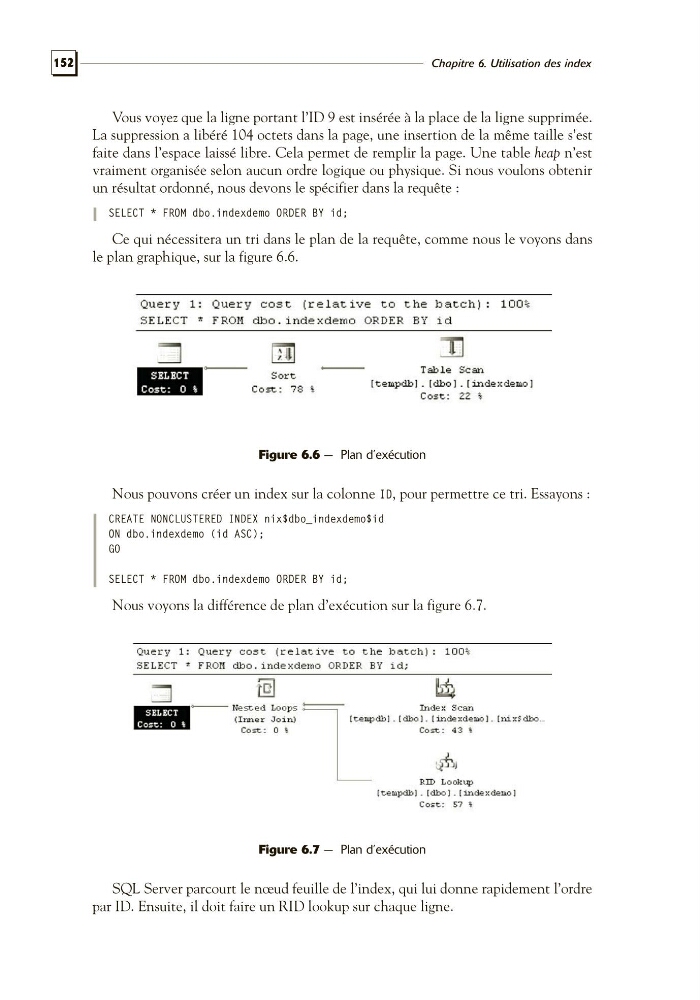
Ce qui nécessitera un tri dans le plan de la requête, comme nous le voyons dans
le plan graphique, sur la figure 6.6.
Figure 6.6 — Plan d’exécution
Nous pouvons créer un index sur la colonne ID, pour permettre ce tri. Essayons :
CREATE NONCLUSTERED INDEX nix$dbo_indexdemo$id
ON dbo.indexdemo (id ASC);
GO
SELECT * FROM dbo.indexdemo ORDER BY id;
Nous voyons la différence de plan d’exécution sur la figure 6.7.
Figure 6.7 — Plan d’exécution
SQL Server parcourt le nœud feuille de l’index, qui lui donne rapidement l’ordre
par ID. Ensuite, il doit faire un RID lookup sur chaque ligne.