

Chapitre 10 – Variables aléatoires à densité
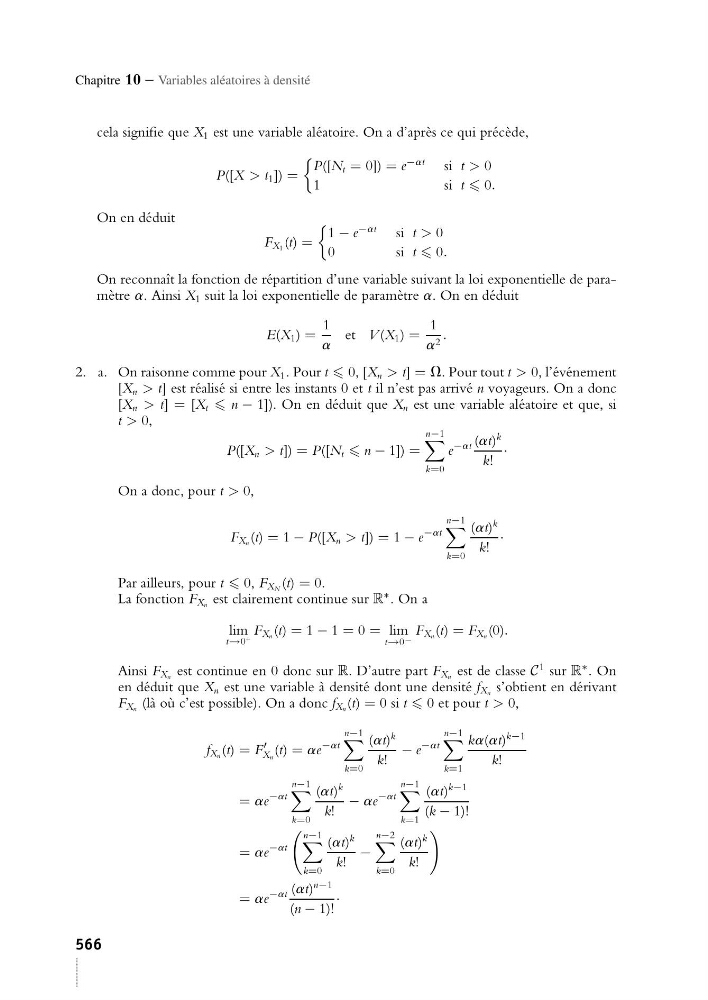
cela signifie que X 1 est une variable aléatoire. On a d’après ce qui précède,
P([X > t 1 ]) =
P([N t = 0]) = e
−at
si t > 0
1
s it 0.
On en déduit
F X1 (t) =
1 − e
−at
si t > 0
0
s i t 0.
On reconnaît la fonction de répartition d’une variable suivant la loi exponentielle de paramètre a. Ainsi X 1 suit la loi exponentielle de paramètre a. On en déduit
E(X 1 ) =
1
a
et V (X 1 ) =
1
a 2 .
2. a. On raisonne comme pour X 1 . Pour t 0, [X n > t] = V. Pour tout t > 0, l’événement
[X n > t] est réalisé si entre les instants 0 et t il n’est pas arrivé n voyageurs. On a donc
[X n > t] = [X t n − 1]). On en déduit que X n est une variable aléatoire et que, si
t > 0,
P([X n > t]) = P([N t n − 1]) =
n−1
k=0
e
−at (at)
k
k!
·
On a donc, pour t > 0,
F Xn (t) = 1 − P([X n > t]) = 1 − e
−at
n−1
k=0
(at)
k
k!
·
Par ailleurs, pour t 0, F XN (t) = 0.
La fonction F Xn est clairement continue sur R
∗ . On a
lim
t→0 +
F Xn (t) = 1 − 1 = 0 = lim
t→0 −
F Xn (t) = F Xn (0).
Ainsi F Xn est continue en 0 donc sur R. D’autre part F Xn est de classe C
1 sur R
∗ . On
en déduit que X n est une variable à densité dont une densité f Xn s’obtient en dérivant
F Xn (là où c’est possible). On a donc f Xn (t) = 0 si t 0 et pour t > 0,
f Xn (t) = F
Xn (t) = ae
−at
n−1
k=0
(at)
k
k!
− e
−at
n−1
k=1
ka(at)
k−1
k!
= ae
−at
n−1
k=0
(at)
k
k!
− ae
−at
n−1
k=1
(at)
k−1
(k − 1)!
= ae
−at
n−1
k=0
(at)
k
k!
−
n−2
k=0
(at)
k
k!
= ae
−at (at)
n−1
(n − 1)!
·
566