

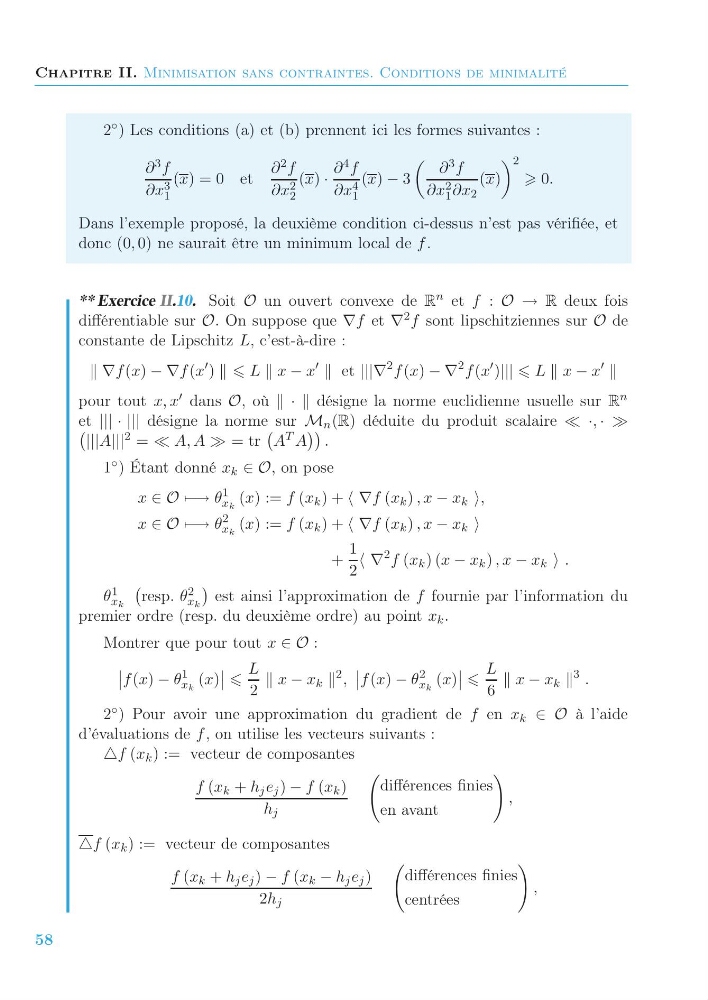
Chapitre II. Minimisation sans contraintes. Conditions de minimalité
2 ◦ ) Les conditions (a) et (b) prennent ici les formes suivantes :
∂ 3 f
∂x 3
1
(x) = 0 et
∂ 2 f
∂x 2
2
(x) ·
∂ 4 f
∂x 4
1
(x) − 3
∂ 3 f
∂x 2
1 ∂x 2
(x)
2
0.
Dans l’exemple proposé, la deuxième condition ci-dessus n’est pas vérifiée, et
donc (0, 0) ne saurait être un minimum local de f .
** Exercice II.10. Soit O un ouvert convexe de R n et f : O → R deux fois
différentiable sur O. On suppose que ∇f et ∇ 2 f sont lipschitziennes sur O de
constante de Lipschitz L, c’est-à-dire :
∇f (x) − ∇f (x
) L x − x
et |||∇
2 f (x) − ∇
2 f (x
)||| L x − x
pour tout x, x dans O, où · · désigne la norme euclidienne usuelle sur R n
et ||| · ||| désigne la norme sur M n (R) déduite du produit scalaire ·, · ·
|||A||| 2 = A, A = tr
A T A
.
1 ◦ ) Étant donné x k ∈ O, on pose
x ∈ O −→ θ
1
x k
(x) := f (x k ) + ∇f (x k ) , x − x k ,
x ∈ O −→ θ
2
x k
(x) := f (x k ) + ∇f (x k ) , x − x k
+
1
2
∇
2 f (x k ) (x − x k ) , x − x k .
θ 1
x k
resp. θ 2
x k
est ainsi l’approximation de f fournie par l’information du
premier ordre (resp. du deuxième ordre) au point x k .
Montrer que pour tout x ∈ O :
f (x) − θ
1
x k
(x)
L
2
x − x k
2 ,
f (x) − θ
2
x k
(x)
L
6
x − x k
3 .
2 ◦ ) Pour avoir une approximation du gradient de f en x k ∈ O à l’aide
d’évaluations de f , on utilise les vecteurs suivants :
f (x k ) := vecteur de composantes
f (x k + h j e j ) − f (x k )
h j
différences finies
en avant
,
f (x k ) := vecteur de composantes
f (x k + h j e j ) − f (x k − h j e j )
2h j
différences finies
centrées
,
58