

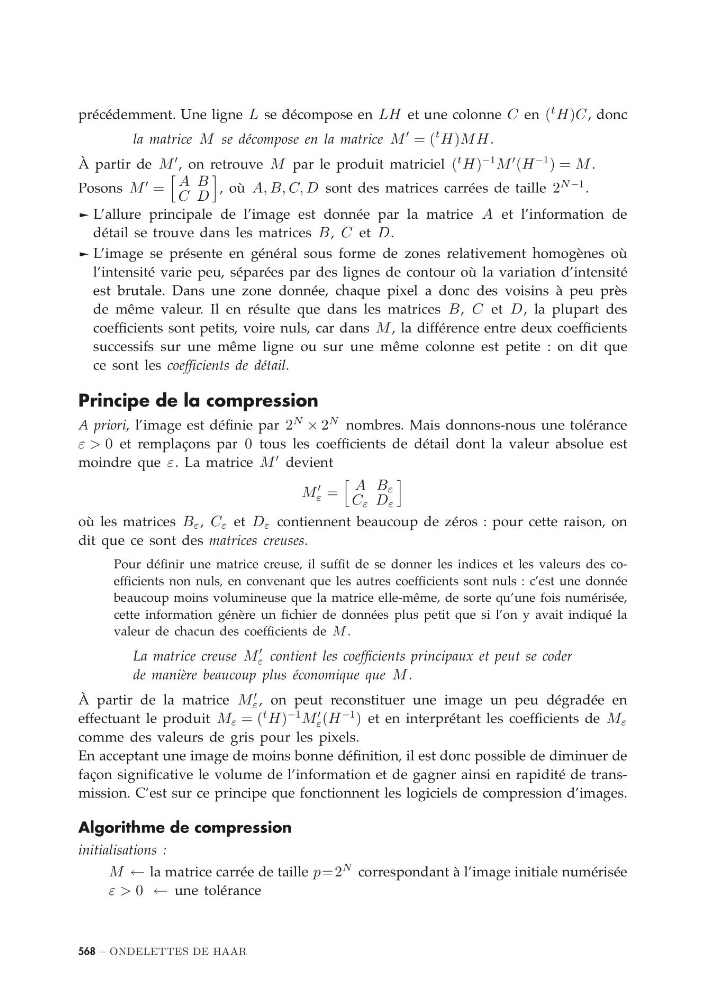
précédemment. Une ligne L se décompose en LH et une colonne C en (
t H)C , donc
la matrice M se décompose en la matrice M
= (
t H)MH .
À partir de M
, on retrouve M par le produit matriciel (
t H)
−1 M
(H
−1 ) = M .
Posons M
=
A B
C D
, où A, B, C, D sont des matrices carrées de taille 2
N −1 .
® L’allure principale de l’image est donnée par la matrice A et l’information de
détail se trouve dans les matrices B, C et D.
® L’image se présente en général sous forme de zones relativement homogènes où
l’intensité varie peu, séparées par des lignes de contour où la variation d’intensité
est brutale. Dans une zone donnée, chaque pixel a donc des voisins à peu près
de même valeur. Il en résulte que dans les matrices B, C et D, la plupart des
coefficients sont petits, voire nuls, car dans M , la différence entre deux coefficients
successifs sur une même ligne ou sur une même colonne est petite : on dit que
ce sont les coefficients de détail.
Principe de la compression
A priori, l’image est définie par 2
N
× 2
N nombres. Mais donnons-nous une tolérance
ε > 0 et remplaçons par 0 tous les coefficients de détail dont la valeur absolue est
moindre que ε. La matrice M
devient
M
ε =
A B ε
C ε D ε
où les matrices B ε , C ε et D ε contiennent beaucoup de zéros : pour cette raison, on
dit que ce sont des matrices creuses.
Pour définir une matrice creuse, il suffit de se donner les indices et les valeurs des coefficients non nuls, en convenant que les autres coefficients sont nuls : c’est une donnée
beaucoup moins volumineuse que la matrice elle-même, de sorte qu’une fois numérisée,
cette information génère un fichier de données plus petit que si l’on y avait indiqué la
valeur de chacun des coefficients de M .
La matrice creuse M
ε contient les coefficients principaux et peut se coder
de manière beaucoup plus économique que M .
À partir de la matrice M
ε , on peut reconstituer une image un peu dégradée en
effectuant le produit M ε = (
t H)
−1 M
ε (H
−1 ) et en interprétant les coefficients de M ε
comme des valeurs de gris pour les pixels.
En acceptant une image de moins bonne définition, il est donc possible de diminuer de
façon significative le volume de l’information et de gagner ainsi en rapidité de transmission. C’est sur ce principe que fonctionnent les logiciels de compression d’images.
Algorithme de compression
initialisations :
M ← la matrice carrée de taille p=2
N correspondant à l’image initiale numérisée
ε > 0 ← une tolérance
568 – ONDELETTES DE HAAR