

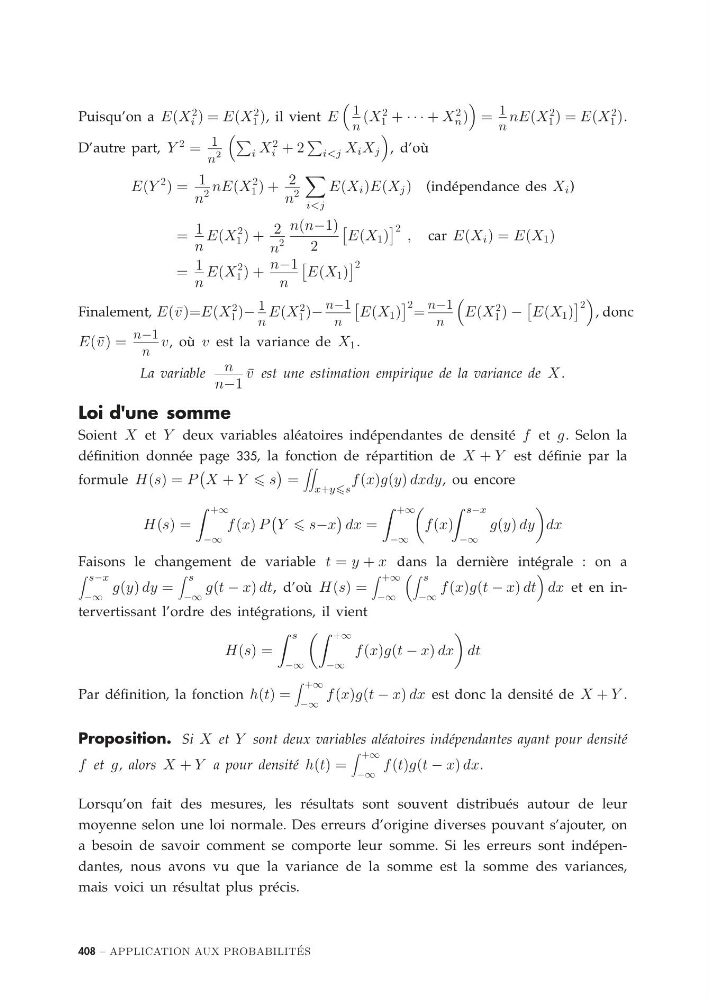
Puisqu’on a E(X
2
i ) = E(X
2
1 ), il vient E
1
n
(X
2
1 + · · · + X
2
n )
= 1
n
nE(X
2
1 ) = E(X
2
1 ).
D’autre part, Y
2 = 1
n
2
i X
2
i + 2
i
E(Y
2 ) = 1
n
2
nE(X
2
1 ) + 2
n
2
i
= 1
n
E(X
2
1 ) + 2
n
2
n(n−1)
2
E(X 1 )
2 , car E(X i ) = E(X 1 )
= 1
n
E(X
2
1 ) +
n−1
n
E(X 1 )
2
Finalement, E(v)=E(X
2
1 )− 1
n
E(X
2
1 )−
n−1
n
E(X 1 )
2 =
n−1
n
E(X
2
1 ) −
E(X 1 )
2
, donc
E(v) =
n−1
n
v, où v est la variance de X 1 .
La variable n
n−1
v est une estimation empirique de la variance de X .
Loi d'une somme
Soient X et Y deux variables aléatoires indépendantes de densité f et g. Selon la
définition donnée page 335, la fonction de répartition de X + Y est définie par la
formule H(s) = P
X + Y s
=
x+ys
f (x)g(y) dxdy, ou encore
H(s) =
+∞
−∞
f (x) P
Y s−x
dx =
+∞
−∞
f (x)
s−x
−∞
g(y) dy
dx
Faisons le changement de variable t = y + x dans la dernière intégrale : on a
s−x
−∞
g(y) dy =
s
−∞
g(t − x) dt, d’où H(s) =
+∞
−∞
s
−∞
f (x)g(t − x) dt
dx et en intervertissant l’ordre des intégrations, il vient
H(s) =
s
−∞
+∞
−∞
f (x)g(t − x) dx
dt
Par définition, la fonction h(t) =
+∞
−∞
f (x)g(t − x) dx est donc la densité de X + Y .
Proposition. Si X et Y sont deux variables aléatoires indépendantes ayant pour densité
f et g, alors X + Y a pour densité h(t) =
+∞
−∞
f (t)g(t − x) dx.
Lorsqu’on fait des mesures, les résultats sont souvent distribués autour de leur
moyenne selon une loi normale. Des erreurs d’origine diverses pouvant s’ajouter, on
a besoin de savoir comment se comporte leur somme. Si les erreurs sont indépendantes, nous avons vu que la variance de la somme est la somme des variances,
mais voici un résultat plus précis.
408 – APPLICATION AUX PROBABILIT ´
ES
2
i ) = E(X
2
1 ), il vient E
1
n
(X
2
1 + · · · + X
2
n )
= 1
n
nE(X
2
1 ) = E(X
2
1 ).
D’autre part, Y
2 = 1
n
2
i X
2
i + 2
i
E(Y
2 ) = 1
n
2
nE(X
2
1 ) + 2
n
2
i
= 1
n
E(X
2
1 ) + 2
n
2
n(n−1)
2
E(X 1 )
2 , car E(X i ) = E(X 1 )
= 1
n
E(X
2
1 ) +
n−1
n
E(X 1 )
2
Finalement, E(v)=E(X
2
1 )− 1
n
E(X
2
1 )−
n−1
n
E(X 1 )
2 =
n−1
n
E(X
2
1 ) −
E(X 1 )
2
, donc
E(v) =
n−1
n
v, où v est la variance de X 1 .
La variable n
n−1
v est une estimation empirique de la variance de X .
Loi d'une somme
Soient X et Y deux variables aléatoires indépendantes de densité f et g. Selon la
définition donnée page 335, la fonction de répartition de X + Y est définie par la
formule H(s) = P
X + Y s
=
x+ys
f (x)g(y) dxdy, ou encore
H(s) =
+∞
−∞
f (x) P
Y s−x
dx =
+∞
−∞
f (x)
s−x
−∞
g(y) dy
dx
Faisons le changement de variable t = y + x dans la dernière intégrale : on a
s−x
−∞
g(y) dy =
s
−∞
g(t − x) dt, d’où H(s) =
+∞
−∞
s
−∞
f (x)g(t − x) dt
dx et en intervertissant l’ordre des intégrations, il vient
H(s) =
s
−∞
+∞
−∞
f (x)g(t − x) dx
dt
Par définition, la fonction h(t) =
+∞
−∞
f (x)g(t − x) dx est donc la densité de X + Y .
Proposition. Si X et Y sont deux variables aléatoires indépendantes ayant pour densité
f et g, alors X + Y a pour densité h(t) =
+∞
−∞
f (t)g(t − x) dx.
Lorsqu’on fait des mesures, les résultats sont souvent distribués autour de leur
moyenne selon une loi normale. Des erreurs d’origine diverses pouvant s’ajouter, on
a besoin de savoir comment se comporte leur somme. Si les erreurs sont indépendantes, nous avons vu que la variance de la somme est la somme des variances,
mais voici un résultat plus précis.
408 – APPLICATION AUX PROBABILIT ´
ES