

et de même ∂U
∂x 2
= b
x 2
U (x 1 , x 2 , x 3 ), ∂U
∂x 3
= c
x 3
U (x 1 , x 2 , x 3 ), d’où
− − − − − − − − − →
Grad U (x 1 , x 2 , x 3 ) = U (x 1 , x 2 , x 3 )
a
x 1
, b
x 2
, c
x 3
Pour que les gradients de g et de u soient colinéaires, il doit exister un nombre λ tel que
p 1 = λ a
x 1
, p 2 = λ b
x 2
, p 3 = λ c
x 3
Il vient alors p 1 x 1 =λa, p 2 x 2 =λb, p 3 x 3 =λc ; en ajoutant, on obtient R=p 1 x 1 +p 2 x 2 +p 3 x 3 =
λ(a + b + c) et λ =
R
a + b + c
. Finalement, la solution est
x 1 =
aR
p 1 (a + b + c)
, x 2 =
bR
p 2 (a + b + c)
, x 3 =
cR
p 3 (a + b + c)
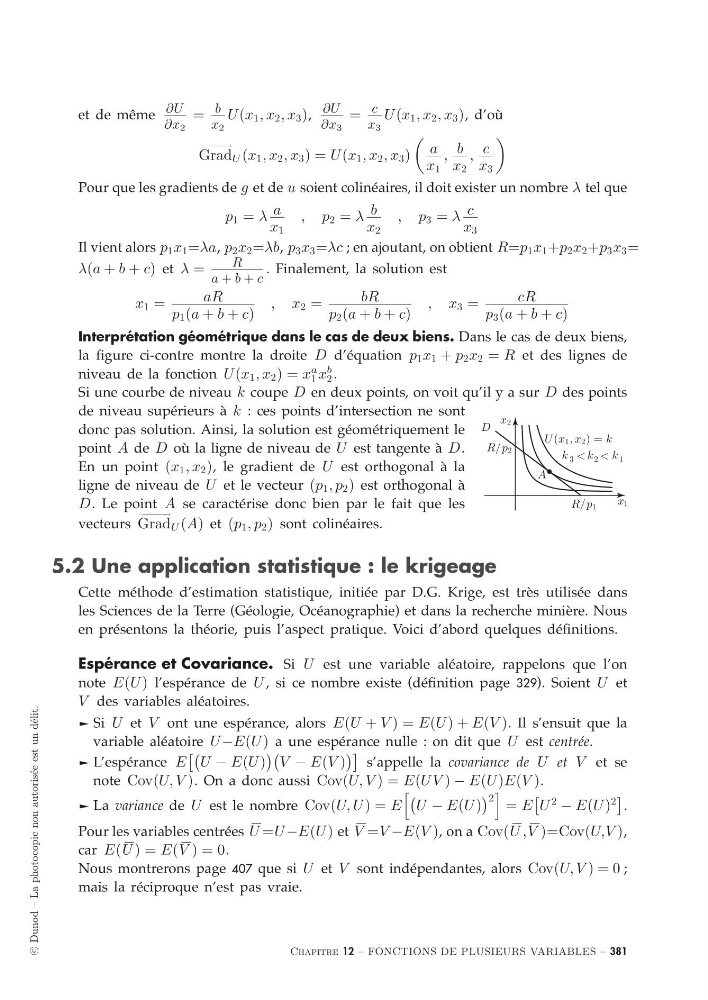
Interprétation géométrique dans le cas de deux biens. Dans le cas de deux biens,
la figure ci-contre montre la droite D d’équation p 1 x 1 + p 2 x 2 = R et des lignes de
niveau de la fonction U (x 1 , x 2 ) = x
a
1 x
b
2 .
1
2
x
x
D
A
U (x 1
1
2
3
, x 2 ) = k
k
k
< k <
R/p 2
R/p 1
Si une courbe de niveau k coupe D en deux points, on voit qu’il y a sur D des points
de niveau supérieurs à k : ces points d’intersection ne sont
donc pas solution. Ainsi, la solution est géométriquement le
point A de D où la ligne de niveau de U est tangente à D.
En un point (x 1 , x 2 ), le gradient de U est orthogonal à la
ligne de niveau de U et le vecteur (p 1 , p 2 ) est orthogonal à
D. Le point A se caractérise donc bien par le fait que les
vecteurs
− − − − − − − − − →
Grad U (A) et (p 1 , p 2 ) sont colinéaires.
5.2 Une application statistique : le krigeage
Cette méthode d’estimation statistique, initiée par D.G. Krige, est très utilisée dans
les Sciences de la Terre (Géologie, Océanographie) et dans la recherche minière. Nous
en présentons la théorie, puis l’aspect pratique. Voici d’abord quelques définitions.
Espérance et Covariance. Si U est une variable aléatoire, rappelons que l’on
note E(U ) l’espérance de U , si ce nombre existe (définition page 329). Soient U et
V des variables aléatoires.
® Si U et V ont une espérance, alors E(U + V ) = E(U ) + E(V ). Il s’ensuit que la
variable aléatoire U −E(U ) a une espérance nulle : on dit que U est centrée.
® L’espérance E
U − E(U )
V − E(V )
s’appelle la covariance de U et V et se
note Cov(U, V ). On a donc aussi Cov(U, V ) = E(UV ) − E(U )E(V ).
® La variance de U est le nombre Cov(U, U ) = E
U − E(U )
2
= E
U
2
− E(U )
2
.
Pour les variables centrées U =U −E(U ) et V =V −E(V ), on a Cov(U ,V )=Cov(U,V ),
car E(U ) = E(V ) = 0.
Nous montrerons page 407 que si U et V sont indépendantes, alors Cov(U, V ) = 0 ;
mais la réciproque n’est pas vraie.
Chapitre 12 – FONCTIONS DE PLUSIEURS VARIABLES – 381