

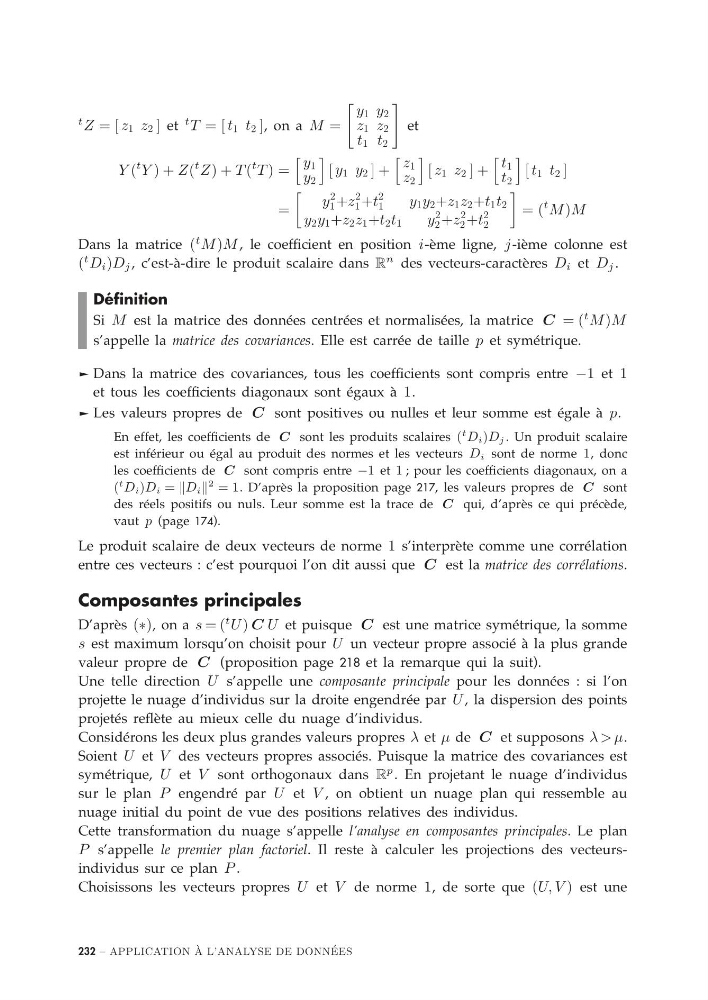
t Z = [ z 1 z 2 ] et
t T = [ t 1 t 2 ], on a M =
y 1 y 2
z 1 z 2
t 1 t 2
et
Y (
t Y ) + Z(
t Z) + T (
t T ) =
y 1
y 2
[ y 1 y 2 ] +
z 1
z 2
[ z 1 z 2 ] +
t 1
t 2
[ t 1 t 2 ]
=
y
2
1 +z
2
1 +t
2
1
y 1 y 2 +z 1 z 2 +t 1 t 2
y 2 y 1 +z 2 z 1 +t 2 t 1
y
2
2 +z
2
2 +t
2
2
= (
t M )M
Dans la matrice (
t M )M , le coefficient en position i-ème ligne, j -ième colonne est
(
t D i )D j , c’est-à-dire le produit scalaire dans R
n des vecteurs-caractères D i et D j .
Définition
Si M est la matrice des données centrées et normalisées, la matrice C = (
t M )M
s’appelle la matrice des covariances. Elle est carrée de taille p et symétrique.
® Dans la matrice des covariances, tous les coefficients sont compris entre −1 et 1
et tous les coefficients diagonaux sont égaux à 1.
® Les valeurs propres de C sont positives ou nulles et leur somme est égale à p.
En effet, les coefficients de C sont les produits scalaires (
t D i )D j . Un produit scalaire
est inférieur ou égal au produit des normes et les vecteurs D i sont de norme 1, donc
les coefficients de C sont compris entre −1 et 1 ; pour les coefficients diagonaux, on a
(
t D i )D i = D i
2 = 1. D’après la proposition page 217, les valeurs propres de C sont
des réels positifs ou nuls. Leur somme est la trace de C qui, d’après ce qui précède,
vaut p (page 174).
Le produit scalaire de deux vecteurs de norme 1 s’interprète comme une corrélation
entre ces vecteurs : c’est pourquoi l’on dit aussi que C est la matrice des corrélations.
Composantes principales
D’après (∗), on a s = (
t U ) C U et puisque C est une matrice symétrique, la somme
s est maximum lorsqu’on choisit pour U un vecteur propre associé à la plus grande
valeur propre de C (proposition page 218 et la remarque qui la suit).
Une telle direction U s’appelle une composante principale pour les données : si l’on
projette le nuage d’individus sur la droite engendrée par U , la dispersion des points
projetés reflète au mieux celle du nuage d’individus.
Considérons les deux plus grandes valeurs propres λ et μ de C et supposons λ > μ.
Soient U et V des vecteurs propres associés. Puisque la matrice des covariances est
symétrique, U et V sont orthogonaux dans R
p . En projetant le nuage d’individus
sur le plan P engendré par U et V , on obtient un nuage plan qui ressemble au
nuage initial du point de vue des positions relatives des individus.
Cette transformation du nuage s’appelle l’analyse en composantes principales. Le plan
P s’appelle le premier plan factoriel. Il reste à calculer les projections des vecteursindividus sur ce plan P .
Choisissons les vecteurs propres U et V de norme 1, de sorte que (U, V ) est une
232 – APPLICATION `
A L’ANALYSE DE DONN ´
EES