

108
8 Algorithme EM et mélanges
En regroupant les termes en fonction des valeurs possibles de Z, on obtient
L(θ, X, Z) =
J
j=1
C j log α(j) +
J
j=1
i∈Aj
log γ m(j),v(j) (X i ).
Théorème 8.1 (Estimation pour modèle complet). La vraisemblance complète atteint son maximum en un point unique ˆ
θ ∈ Θ donné par :
ˆ
α(j) =
C j
n
, ˆ
m(j) =
1
C j
i∈Aj
X i et ˆ
v(j) =
1
C j
i∈Aj
(X i − ˆ
m(j))
2 .
Démonstration. Sous la contrainte α(1) + · · · + α(J) = 1, la fonction θ →
L(θ, X, Z) admet un unique point critique, qui s’avère être un maximum.
Ce résultat ne répond pas à la question initiale puisque, en pratique,
ne sont observées que les tailles des nids x 1 , . . . , x n . Il faudrait plutôt étudier la log-vraisemblance de l’échantillon X 1 , . . . , X n , notée L obs pour logvraisemblance des observations, qui s’écrit :
L obs (θ, X) = log
n
i=1
f θ (X i ) =
n
i=1
log
⎡
⎣
J
j=1
α(j)γ m(j),v(j) (X i )
⎤
⎦ .
Trouver un jeu de paramètres θ qui maximise cette quantité n’est pas facile.
8.3 Résolution du vrai problème
Ne disposant pas de la log-vraisemblance complète L, on la remplace
par son espérance conditionnelle sachant les observations : on définit la logvraisemblance conditionnelle des observations sous la loi de paramètre ˜
θ, que
nous noterons L c (θ, ˜
θ, X), par :
L c (θ, ˜
θ, X) = E ˜
θ (L(θ, X, Z)|X) =
n
i=1
J
j=1
log h θ (X i , j)g ˜
θ (j|X = X i ).
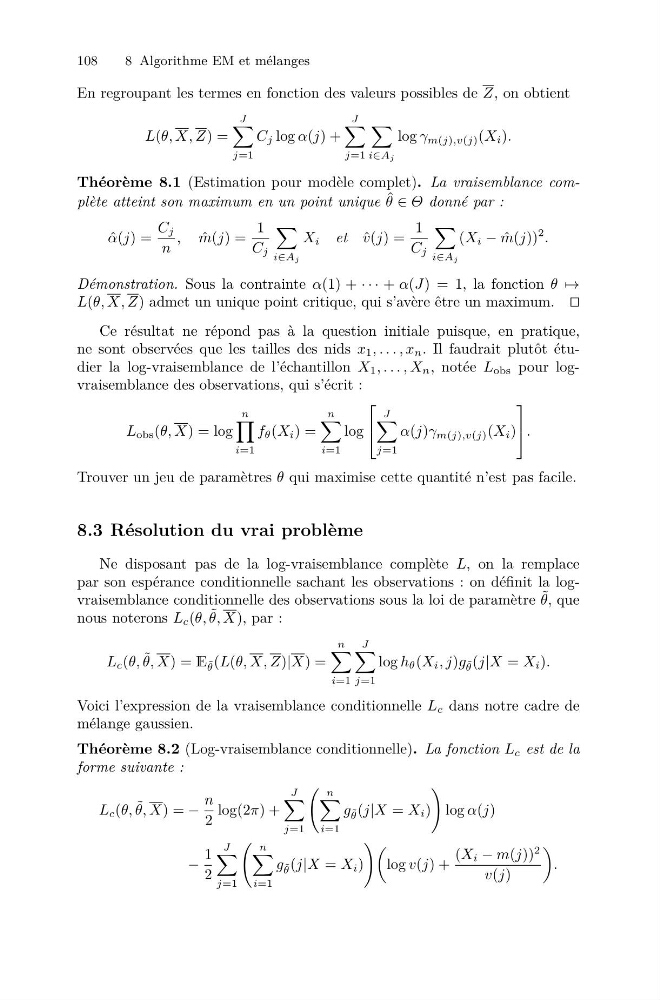
Voici l’expression de la vraisemblance conditionnelle L c dans notre cadre de
mélange gaussien.
Théorème 8.2 (Log-vraisemblance conditionnelle). La fonction L c est de la
forme suivante :
L c (θ, ˜
θ, X) = −
n
2
log(2π) +
J
j=1
n
i=1
g ˜
θ (j|X = X i )
log α(j)
−
1
2
J
j=1
n
i=1
g ˜
θ (j|X = X i )
log v(j) +
(X i − m(j))
2
v(j)
.