

8.3 Résolution du vrai problème
109
Il est aisé de déterminer le maximum de la vraisemblance conditionnelle.
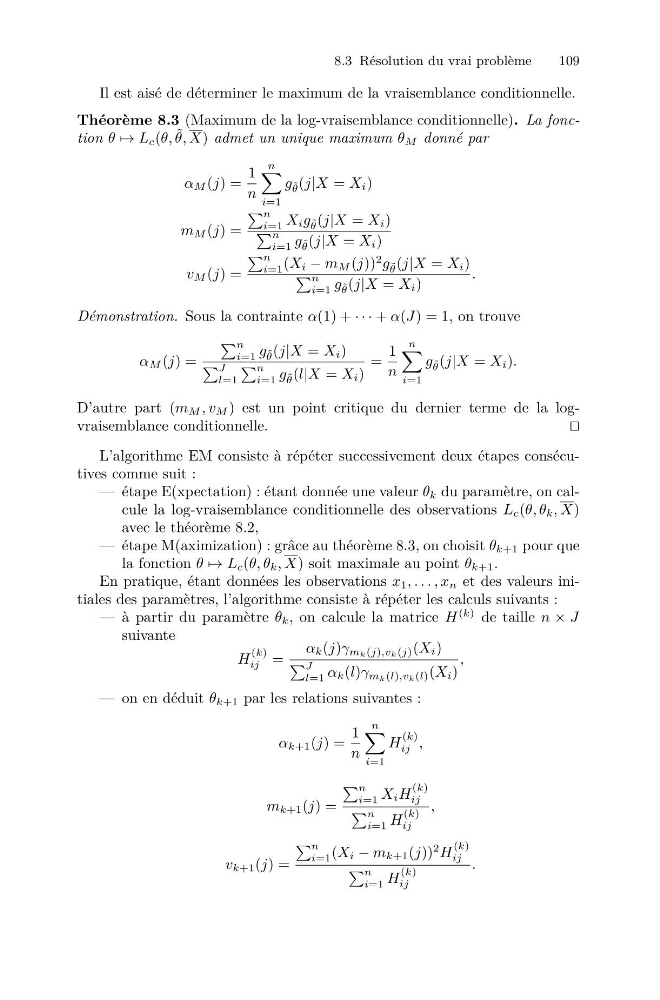
Théorème 8.3 (Maximum de la log-vraisemblance conditionnelle). La fonction θ → L c (θ, ˜
θ, X) admet un unique maximum θ M donné par
α M (j) =
1
n
n
i=1
g ˜
θ (j|X = X i )
m M (j) =
n
i=1 X i g ˜
θ (j|X = X i )
n
i=1 g ˜
θ (j|X = X i )
v M (j) =
n
i=1 (X i − m M (j))
2 g ˜
θ (j|X = X i )
n
i=1 g ˜
θ (j|X = X i )
.
Démonstration. Sous la contrainte α(1) + · · · + α(J) = 1, on trouve
α M (j) =
n
i=1 g ˜
θ (j|X = X i )
J
l=1
n
i=1 g ˜
θ (l|X = X i )
=
1
n
n
i=1
g ˜
θ (j|X = X i ).
D’autre part (m M , v M ) est un point critique du dernier terme de la logvraisemblance conditionnelle.
L’algorithme EM consiste à répéter successivement deux étapes consécutives comme suit :
— étape E(xpectation) : étant donnée une valeur θ k du paramètre, on calcule la log-vraisemblance conditionnelle des observations L c (θ, θ k , X)
avec le théorème 8.2,
— étape M(aximization) : grâce au théorème 8.3, on choisit θ k+1 pour que
la fonction θ → L c (θ, θ k , X) soit maximale au point θ k+1 .
En pratique, étant données les observations x 1 , . . . , x n et des valeurs initiales des paramètres, l’algorithme consiste à répéter les calculs suivants :
— à partir du paramètre θ k , on calcule la matrice H
(k) de taille n × J
suivante
H
(k)
ij =
α k (j)γ m k (j),v k (j) (X i )
J
l=1 α k (l)γ m k (l),v k (l) (X i )
,
— on en déduit θ k+1 par les relations suivantes :
α k+1 (j) =
1
n
n
i=1
H
(k)
ij ,
m k+1 (j) =
n
i=1 X i H
(k)
ij
n
i=1 H
(k)
ij
,
v k+1 (j) =
n
i=1 (X i − m k+1 (j))
2 H
(k)
ij
n
i=1 H
(k)
ij
.