

12.1 Filtre de Kalman-Bucy
353
La fonction p(x n | (y 0 , . . . , y n−1 )) d´ esigne la densit´ e (par rapport `
a
la mesure de Lebesgue sur R
p ) de la loi conditionnelle de X n , sachant
(Y 0 , . . . , Y n−1 ) = (y 0 , . . . , y n−1 ).
Enfin, les fonctions p(x p | x p+1 , (y 0 , . . . , y p )) d´ esignent les densit´ es (par
rapport ` a la mesure de Lebesgue sur R
p ) des lois conditionnelles des ´ etats X p ,
sachant X p+1 = x p+1 , et (Y 0 , . . . , Y p ) = (y 0 , . . . , y p ).
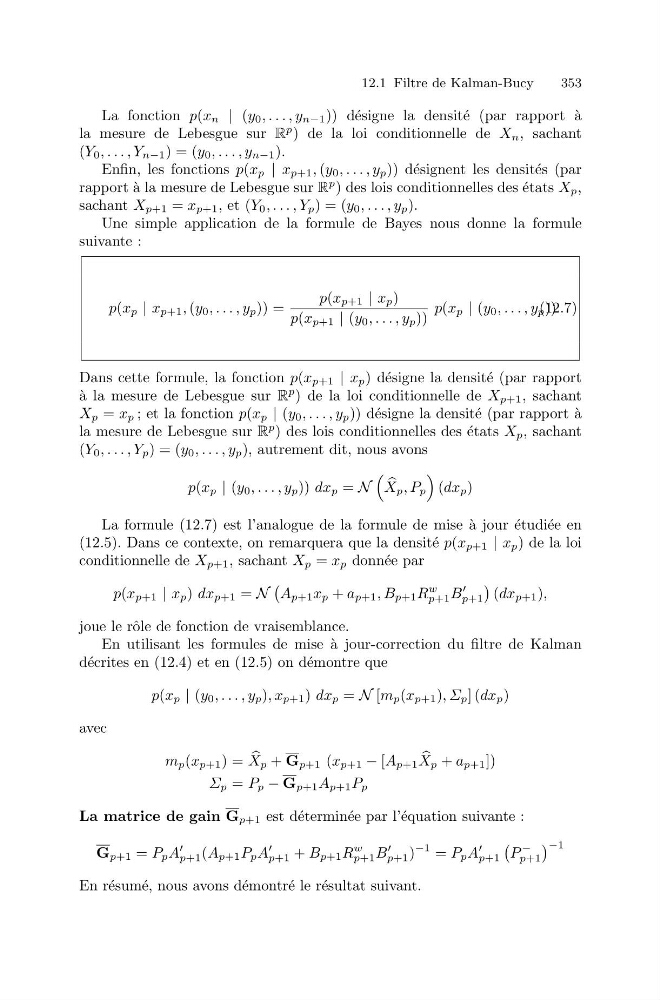
Une simple application de la formule de Bayes nous donne la formule
suivante :
p(x p | x p+1 , (y 0 , . . . , y p )) =
p(x p+1 | x p )
p(x p+1 | (y 0 , . . . , y p ))
p(x p | (y 0 , . . . , y p ))
(12.7)
Dans cette formule, la fonction p(x p+1 | x p ) d´ esigne la densit´ e (par rapport
` a la mesure de Lebesgue sur R
p ) de la loi conditionnelle de X p+1 , sachant
X p = x p ; et la fonction p(x p | (y 0 , . . . , y p )) d´ esigne la densit´ e (par rapport ` a
la mesure de Lebesgue sur R
p ) des lois conditionnelles des ´ etats X p , sachant
(Y 0 , . . . , Y p ) = (y 0 , . . . , y p ), autrement dit, nous avons
p(x p | (y 0 , . . . , y p )) dx p = N
X p , P p
(dx p )
La formule (12.7) est l’analogue de la formule de mise ` a jour ´ etudi´ ee en
(12.5). Dans ce contexte, on remarquera que la densit´ e p(x p+1 | x p ) de la loi
conditionnelle de X p+1 , sachant X p = x p donn´ ee par
p(x p+1 | x p ) dx p+1 = N
A p+1 x p + a p+1 , B p+1 R
w
p+1 B
p+1
(dx p+1 ),
joue le rˆ ole de fonction de vraisemblance.
En utilisant les formules de mise ` a jour-correction du filtre de Kalman
d´ ecrites en (12.4) et en (12.5) on d´ emontre que
p(x p | (y 0 , . . . , y p ), x p+1 ) dx p = N [m p (x p+1 ), Σ p ] (dx p )
avec
m p (x p+1 ) =
X p + G p+1 (x p+1 − [A p+1
X p + a p+1 ])
Σ p = P p − G p+1 A p+1 P p
La matrice de gain G p+1 est d´ etermin´ ee par l’´ equation suivante :
G p+1 = P p A
p+1 (A p+1 P p A
p+1 + B p+1 R
w
p+1 B
p+1 )
−1 = P p A
p+1
P
−
p+1
−1
En r´ esum´ e, nous avons d´ emontr´ e le r´ esultat suivant.