

12.1 Filtre de Kalman-Bucy
349
sont tr` es stables : toute op´ eration lin´ eaire et tout type de conditionnement
entre variables ont ` a nouveau une nature gaussienne. Il est donc impossible
d’´ echapper `
a ces trous noirs gaussiens par des op´ erations lin´ eaires ou par des
formules de conditionnement.
On notera par la suite N (m, R) la mesure gaussienne sur R
d de moyenne
m ∈ R
d , et de matrice de covariance R ∈ R
d×d
N (m, R)(dx)
=
1
(2π) d/2
|R|
exp [−2
−1 (x − m)R
−1 (x − m)
] dx
(12.2)
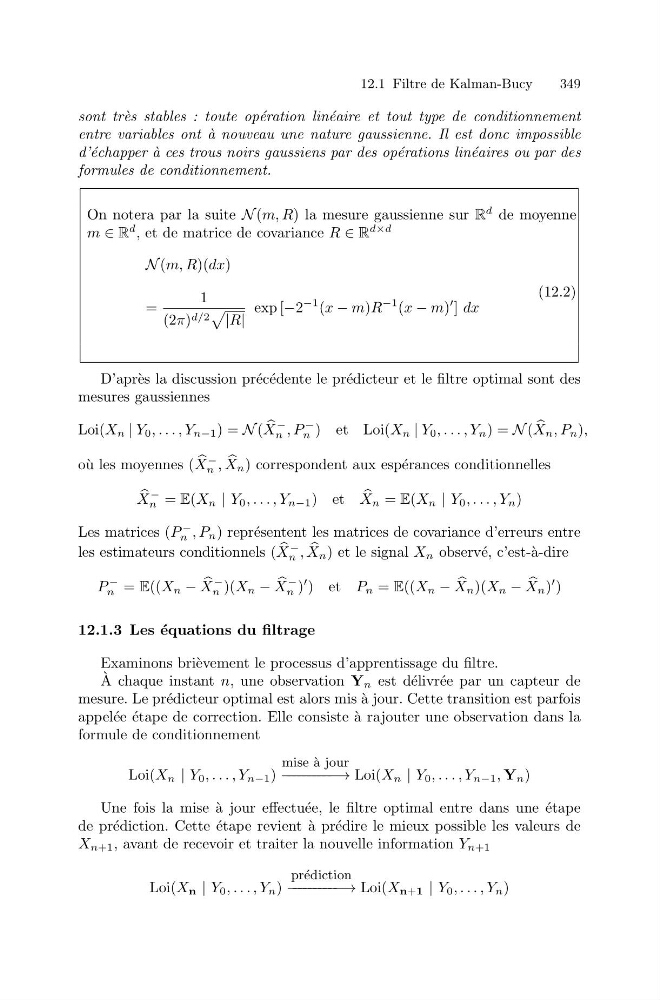
D’apr` es la discussion pr´ ec´ edente le pr´ edicteur et le filtre optimal sont des
mesures gaussiennes
Loi(X n | Y 0 , . . . , Y n−1 ) = N (
X
−
n , P
−
n ) et Loi(X n | Y 0 , . . . , Y n ) = N (
X n , P n ),
o` u les moyennes (
X
−
n ,
X n ) correspondent aux esp´ erances conditionnelles
X
−
n = E(X n | Y 0 , . . . , Y n−1 ) et
X n = E(X n | Y 0 , . . . , Y n )
Les matrices (P
−
n , P n ) repr´ esentent les matrices de covariance d’erreurs entre
les estimateurs conditionnels (
X
−
n ,
X n ) et le signal X n observ´ e, c’est-` a-dire
P
−
n = E((X n −
X
−
n )(X n −
X
−
n )
) et P n = E((X n −
X n )(X n −
X n )
)
12.1.3 Les ´ equations du filtrage
Examinons bri` evement le processus d’apprentissage du filtre.
`
A chaque instant n, une observation Y n est d´ elivr´ ee par un capteur de
mesure. Le pr´ edicteur optimal est alors mis `
a jour. Cette transition est parfois
appel´ ee ´ etape de correction. Elle consiste ` a rajouter une observation dans la
formule de conditionnement
Loi(X n | Y 0 , . . . , Y n−1 )
mise ` a jour
− − − − − − − − − −→ Loi(X n | Y 0 , . . . , Y n−1 , Y n )
Une fois la mise ` a jour effectu´ ee, le filtre optimal entre dans une ´ etape
de pr´ ediction. Cette ´ etape revient ` a pr´ edire le mieux possible les valeurs de
X n+1 , avant de recevoir et traiter la nouvelle information Y n+1
Loi(X n | Y 0 , . . . , Y n )
pr´ ediction
− − − − − − − − − −→ Loi(X n+1 | Y 0 , . . . , Y n )