

158
CHAPITRE 6. SOUS-DIFFÉRENTIELS GÉNÉRALISÉS
Ainsi, la condition d’optimalité (6.32) conduit à la condition d’optimalité
(6.26).
Comme quoi,
"Tout est dans tout et r ´
eciproquement" (Pierre Dac).
2 Sous-différentiation généralisée de fonctions s.c.i. à valeurs
dans R ∪ {+∞}
Comme cela a été indiqué dans l’introduction du chapitre, le désir d’établir des conditions nécessaires d’optimalité dans des problèmes variationnels
ou d’optimisation formulés de manière abstraite et générale conduit à se préoccuper de la sous-différentiation généralisée de fonctions
f : E → R ∪ {+∞}
et donc non localement Lipschitz ni même finies sur E. On considérera tout
de même que (E, ·) est un espace de Banach (il deviendra rapidement
plus précis que cela) et que f est s.c.i. sur E (avec tout ce que cela induit
comme propriétés, cf. Chapitre 1). Nous présentons un choix de quatre de ces
sous-différentiels généralisés, puis les règles de va-et-vient entre l’Analyse
et la Géométrie (non lisses), et enfin un exemple de problème d’optimisation
où la fonction-objectif à minimiser est s.c.i. et rien de plus.
2.1 Un panel de sous-différentiels généralisés
Dans toute la suite, le point de sous-différentiation généralisée considéré x
est un point en lequel f est finie (x ∈ dom f , si on préfère).
• Le sous-différentiel généralisé (ou gradient généralisé) de Clarke
Le concept proposé étend celui établi en 1 `
ere partie pour les fonctions localement Lipschitz. Sans entrer dans les détails de pourquoi et comment on arrive
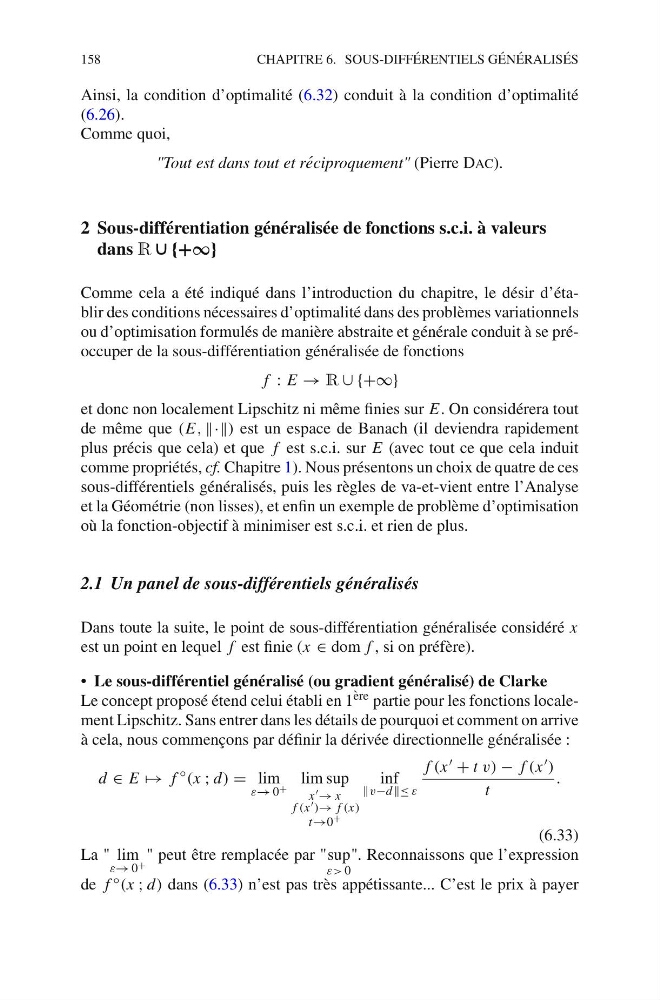
à cela, nous commençons par définir la dérivée directionnelle généralisée :
d ∈ E → f
◦
(x ; d) = lim
ε→ 0 +
lim sup
x → x
f (x )→ f (x)
t→0 +
inf
v−d ≤ ε
f (x + t v) − f (x )
t
.
(6.33)
La " lim
ε→ 0 +
" peut être remplacée par "sup
ε> 0
". Reconnaissons que l’expression
de f ◦ (x ; d) dans (6.33) n’est pas très appétissante... C’est le prix à payer