

3.3 Verarbeitungseinheiten
177
Die Matrix wird aufgeteilt in sogenannte Thread-Blöcke. Jeder Thread-Block
kann auf einen der Kerne in einer GPU abgebildet werden. Jeder Thread-Block
enthält eine Anzahl von Threads und jeder Thread enthält eine Anzahl von Befehlen.
Die Gesamtheit der Berechnungen in Abb. 3.32 bezeichnet man als grid.
∇
Jeder Kern wird versuchen, durch die Ausführung von Threads einen Rechenfortschritt zu erzeugen. Wenn einige Threads blockieren, weil sie z.B. auf den Speicher
warten, wird der Kern einen anderen Thread ausführen. Die Befehle innerhalb eines Threads können ebenfalls gleichzeitig ausgeführt werden, indem beispielsweise
mehrere Fließbänder genutzt werden. Thread-Blöcke können auf aktuellen Prozessoren gleichzeitig ausgeführt werden. Ein schnelles Umschalten zwischen den Threads
und die sich dadurch ergebende Möglichkeit, Speicherlatenz zu verstecken, sind ein
wesentliches Merkmal von GPUs.
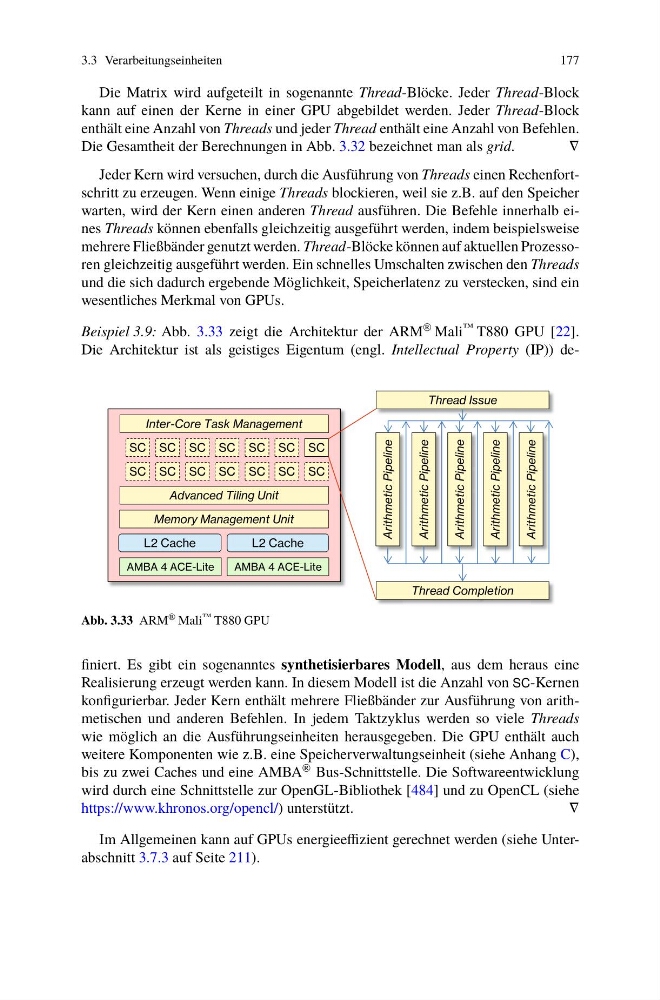
Beispiel 3.9: Abb. 3.33 zeigt die Architektur der ARM ® Mali ™ T880 GPU [22].
Die Architektur ist als geistiges Eigentum (engl. Intellectual Property (IP)) deInter-Core Task Management
SC SC
SC
SC
SC
SC
SC
SC SC
SC
SC
SC
SC
SC
Advanced Tiling Unit
Memory Management Unit
L2 Cache
L2 Cache
AMBA 4 ACE-Lite
AMBA 4 ACE-Lite
Thread Issue
Thread Completion
Arithmetic Pipeline
Arithmetic Pipeline
Arithmetic Pipeline
Arithmetic Pipeline
Arithmetic Pipeline
Abb. 3.33 ARM ® Mali ™ T880 GPU
finiert. Es gibt ein sogenanntes synthetisierbares Modell, aus dem heraus eine
Realisierung erzeugt werden kann. In diesem Modell ist die Anzahl von SC-Kernen
konfigurierbar. Jeder Kern enthält mehrere Fließbänder zur Ausführung von arithmetischen und anderen Befehlen. In jedem Taktzyklus werden so viele Threads
wie möglich an die Ausführungseinheiten herausgegeben. Die GPU enthält auch
weitere Komponenten wie z.B. eine Speicherverwaltungseinheit (siehe Anhang C),
bis zu zwei Caches und eine AMBA ® Bus-Schnittstelle. Die Softwareentwicklung
wird durch eine Schnittstelle zur OpenGL-Bibliothek [484] und zu OpenCL (siehe
https://www.khronos.org/opencl/) unterstützt.
∇
Im Allgemeinen kann auf GPUs energieeffizient gerechnet werden (siehe Unterabschnitt 3.7.3 auf Seite 211).