

176
3 Hardware eingebetteter Systeme
Abb. 3.31 ARM ® big.LITTLE-Architektur
mit Cortex ® A-7- und Cortex ® A-15-Kernen
Interrupt-Kontrolle
Cortex-A15
Kern
L1 Cache
Kern
CCI-400 Coherent Interconnect
Cortex-A7
Kern
L1 Cache
Kern
Graphikprozessoren
Früher benutzten viele Rechensysteme spezielle Graphikprozessoren (engl. Graphics
Processing Units (GPUs)), um eine ansprechende Ausgabe beispielsweise auf Bildschirmen zu erzeugen. Diese fest verdrahteten Prozessoren konnten nur StandardGraphikalgorithmen ausführen und waren damit zu unflexibel. Daher wurden sie
durch programmierbare GPUs ersetzt und führten so zu allgemeinen Berechnungen
auf Graphikeinheiten (engl. General Purpose Computation on Graphics Processing
Units (GPGPU)). Die benötigte Performanz erzielen aktuelle GPUs durch die Möglichkeit, sehr viele Berechnungen in Form von feingranularen Fäden (engl. Threads)
gleichzeitig auszuführen. Ziel ist dabei, möglichst viele der zahlreichen gleichartigen
Recheneinheiten gut auszulasten.
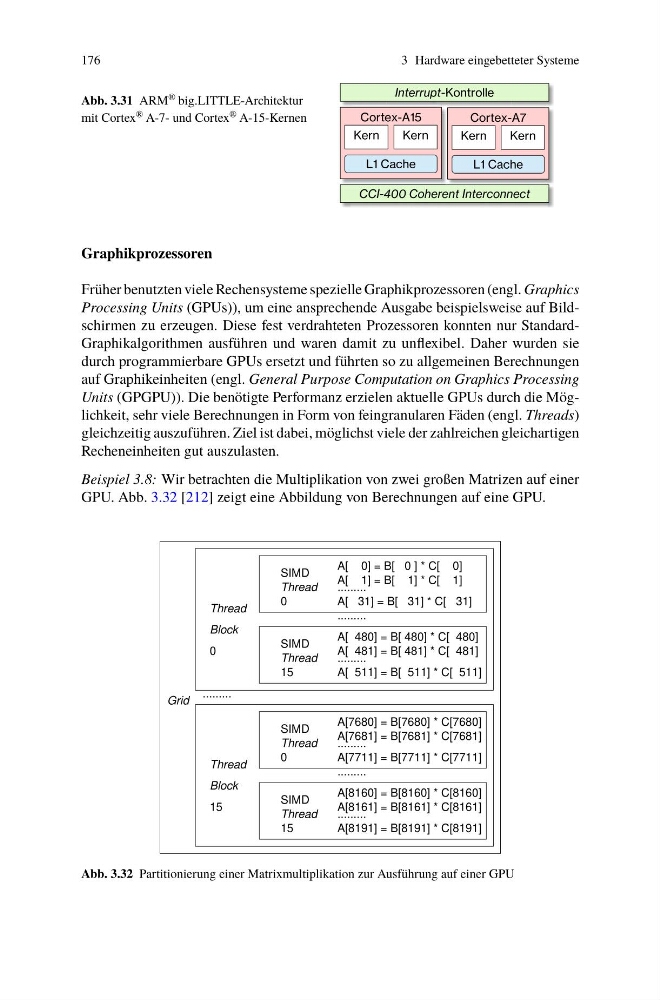
Beispiel 3.8: Wir betrachten die Multiplikation von zwei großen Matrizen auf einer
GPU. Abb. 3.32 [212] zeigt eine Abbildung von Berechnungen auf eine GPU.
A[ 0] = B[ 0 ] * C[ 0]
A[ 1] = B[ 1] * C[ 1]
A[ 31] = B[ 31] * C[ 31]
A[ 511] = B[ 511] * C[ 511]
A[ 481] = B[ 481] * C[ 481]
.........
.........
.........
.........
Thread
0
SIMD
Thread
SIMD
15
A[7681] = B[7681] * C[7681]
A[7711] = B[7711] * C[7711]
A[8160] = B[8160] * C[8160]
A[8161] = B[8161] * C[8161]
A[8191] = B[8191] * C[8191]
.........
.........
.........
0
SIMD
Thread
Thread
SIMD
15
Thread
Block
0
Thread
Block
15
Grid
A[7680] = B[7680] * C[7680]
A[ 480] = B[ 480] * C[ 480]
Abb. 3.32 Partitionierung einer Matrixmultiplikation zur Ausführung auf einer GPU