

1
126 Biostatistiques pour le clinicien
Tableau III – Modèle de régression linéaire.
y = b + ax + e
Dans cette équation :
– y et x sont les deux variables quantitatives que l’on modélise, y étant la variable
expliquée et x la variable expliquante ;
– b est une constante appelée ordonnée à l’origine (intercept en anglais) car elle
représente la valeur de y lorsque x est égal à 0.
– a quantifie l’amplitude des variations de y en fonction de celles de x ; c’est la pente
de la droite de régression (slope en anglais).
– e est un terme d’erreur, que l’on suppose de distribution normale, de moyenne
nulle et de variance fixée σ².
Modèle prédictif
La régression permet, à partir d’une association observée, de
développer un modèle prédictif, c’est-à-dire, à partir d’une valeur
d’une variable x, de prédire la valeur de l’autre variable y. La droite
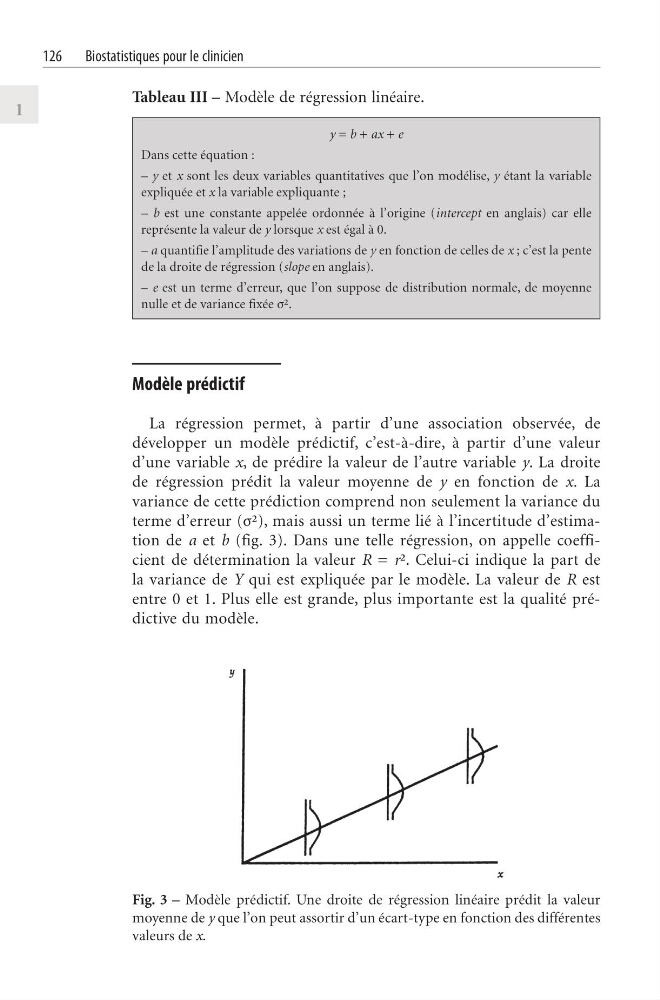
de régression prédit la valeur moyenne de y en fonction de x. La
variance de cette prédiction comprend non seulement la variance du
terme d’erreur (σ²), mais aussi un terme lié à l’incertitude d’estimation de a et b (fig. 3). Dans une telle régression, on appelle coefficient de détermination la valeur R = r². Celui-ci indique la part de
la variance de Y qui est expliquée par le modèle. La valeur de R est
entre 0 et 1. Plus elle est grande, plus importante est la qualité prédictive du modèle.
Fig. 3 – Modèle prédictif. Une droite de régression linéaire prédit la valeur
moyenne de y que l’on peut assortir d’un écart- type en fonction des différentes
valeurs de x.