

4
96
Biostatistiques pour le clinicien
que montre encore, de façon plus générale, le calcul du nombre de
sujets à inclure pour des risques donnés et en fonction des résultats
connus du « produit » de référence et espéré du nouveau « produit »
(tableau XVI).
3. Pour une même différence entre la valeur connue du produit de référence et du nouveau produit, plus les valeurs sont proches de 50 %,
plus le nombre de sujets qu’il est nécessaire d’inclure est élevé. Dans le
tableau XV, si l’on passe de 10 % à 20 % il convient d’inclure 263 sujets
par groupes. Si l’on passe de 30 % à 40 %, il faut inclure 473 sujets.
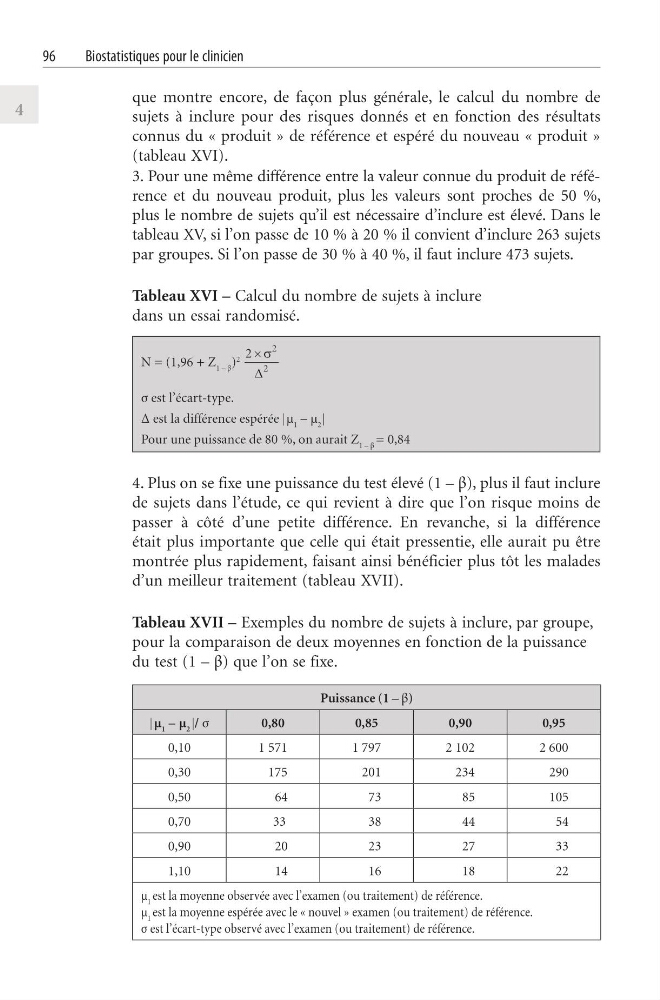
Tableau XVI – Calcul du nombre de sujets à inclure
dans un essai randomisé.
N = (1,96 + Z 1 – β )
2
2
2
2 u V
'
σ est l’écart-type.
Δ est la différence espérée _μ 1 – μ 2 _
Pour une puissance de 80 %, on aurait Z 1 – β = 0,84
4. Plus on se fixe une puissance du test élevé (1 – β), plus il faut inclure
de sujets dans l’étude, ce qui revient à dire que l’on risque moins de
passer à côté d’une petite différence. En revanche, si la différence
était plus importante que celle qui était pressentie, elle aurait pu être
montrée plus rapidement, faisant ainsi bénéficier plus tôt les malades
d’un meilleur traitement (tableau XVII).
Tableau XVII – Exemples du nombre de sujets à inclure, par groupe,
pour la comparaison de deux moyennes en fonction de la puissance
du test (1 – β) que l’on se fixe.
Puissance (1 – β)
_ μ 1 – μ 2 _/ σ
0,80
0,85
0,90
0,95
0,10
1 571
1 797
2 102
2 600
0,30
175
201
234
290
0,50
64
73
85
105
0,70
33
38
44
54
0,90
20
23
27
33
1,10
14
16
18
22
μ 1 est la moyenne observée avec l’examen (ou traitement) de référence.
μ 1 est la moyenne espérée avec le « nouvel » examen (ou traitement) de référence.
σ est l’écart-type observé avec l’examen (ou traitement) de référence.