

44
Statistique appliquée aux sciences de la vie
μ μ ^
fréquences
2
3
4
5
6
7
8
9
0
500
1000
1500
2000
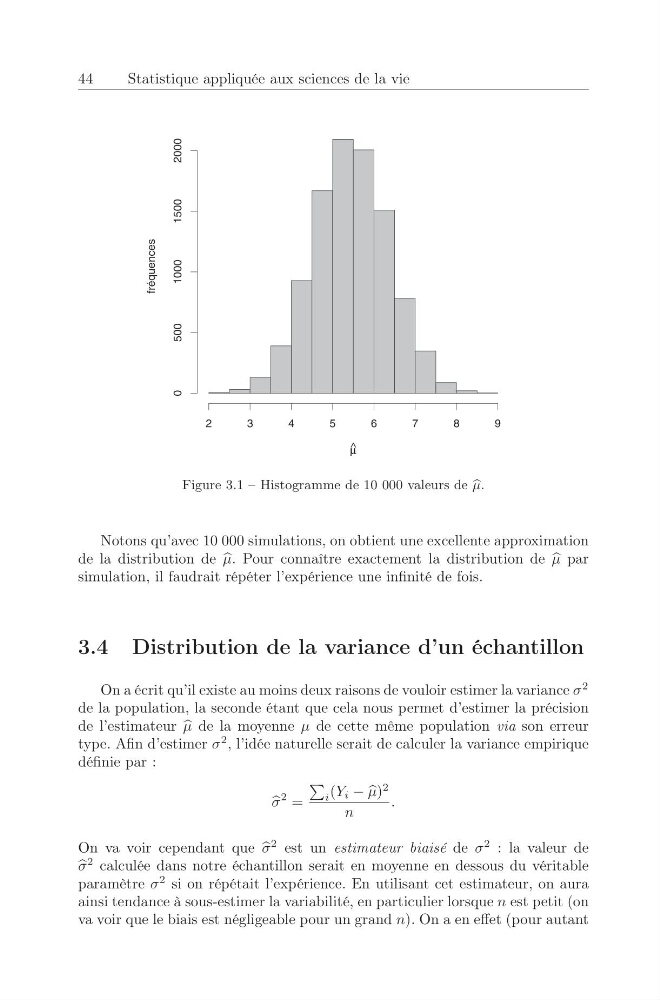
Figure 3.1 – Histogramme de 10 000 valeurs de b
μ.
Notons qu’avec 10 000 simulations, on obtient une excellente approximation
de la distribution de
μ. Pour connaître exactement la distribution de
μ par
simulation, il faudrait répéter l’expérience une infinité de fois.
3.4 Distribution de la variance d’un échantillon
On a écrit qu’il existe au moins deux raisons de vouloir estimer la variance σ
2
de la population, la seconde étant que cela nous permet d’estimer la précision
de l’estimateur
μ de la moyenne μ de cette même population via son erreur
type. Afin d’estimer σ
2 , l’idée naturelle serait de calculer la variance empirique
définie par :
σ
2 =
i (Y i −
μ)
2
n
.
On va voir cependant que
σ
2 est un estimateur biaisé de σ
2 : la valeur de
σ
2 calculée dans notre échantillon serait en moyenne en dessous du véritable
paramètre σ
2 si on répétait l’expérience. En utilisant cet estimateur, on aura
ainsi tendance à sous-estimer la variabilité, en particulier lorsque n est petit (on
va voir que le biais est négligeable pour un grand n). On a en effet (pour autant