

296
Statistique appliquée aux sciences de la vie
De même, à consommation de tabac égale, on estime les odds-ratios suivants :
• exp(0.290) = 1.336 entre les non-buveurs et les buveurs avec 1–9 grammes
par jour
• exp(0.844 − 0.290) = 1.740 entre les buveurs avec 1–9 grammes et les
buveurs avec 10–44 grammes par jour
• exp(1.378 − 0.844) = 1.706 entre les les buveurs avec 10–44 et les buveurs
avec plus de 45 grammes par jour.
On remarque que les odds-ratios comparant deux modalités adjacentes sont assez
proches les uns des autres, à la fois pour le tabac et pour l’alcool. Ceci nous
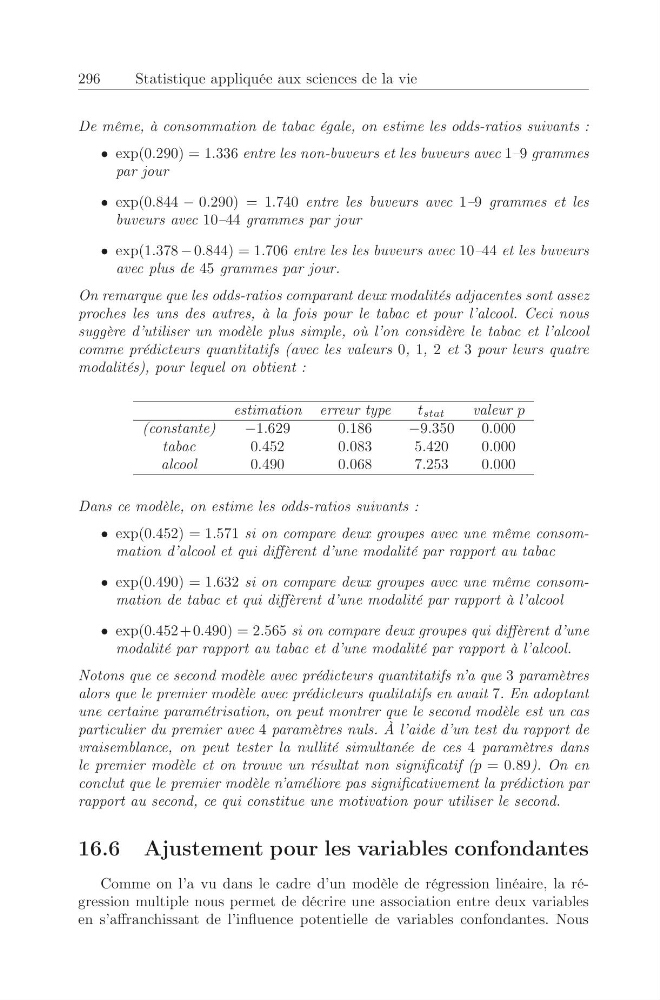
suggère d’utiliser un modèle plus simple, où l’on considère le tabac et l’alcool
comme prédicteurs quantitatifs (avec les valeurs 0, 1, 2 et 3 pour leurs quatre
modalités), pour lequel on obtient :
estimation erreur type
t stat
valeur p
(constante)
−1.629
0.186
−9.350
0.000
tabac
0.452
0.083
5.420
0.000
alcool
0.490
0.068
7.253
0.000
Dans ce modèle, on estime les odds-ratios suivants :
• exp(0.452) = 1.571 si on compare deux groupes avec une même consommation d’alcool et qui diffèrent d’une modalité par rapport au tabac
• exp(0.490) = 1.632 si on compare deux groupes avec une même consommation de tabac et qui diffèrent d’une modalité par rapport à l’alcool
• exp(0.452+0.490) = 2.565 si on compare deux groupes qui diffèrent d’une
modalité par rapport au tabac et d’une modalité par rapport à l’alcool.
Notons que ce second modèle avec prédicteurs quantitatifs n’a que 3 paramètres
alors que le premier modèle avec prédicteurs qualitatifs en avait 7. En adoptant
une certaine paramétrisation, on peut montrer que le second modèle est un cas
particulier du premier avec 4 paramètres nuls. À l’aide d’un test du rapport de
vraisemblance, on peut tester la nullité simultanée de ces 4 paramètres dans
le premier modèle et on trouve un résultat non significatif (p = 0.89). On en
conclut que le premier modèle n’améliore pas significativement la prédiction par
rapport au second, ce qui constitue une motivation pour utiliser le second.
16.6 Ajustement pour les variables confondantes
Comme on l’a vu dans le cadre d’un modèle de régression linéaire, la régression multiple nous permet de décrire une association entre deux variables
en s’affranchissant de l’influence potentielle de variables confondantes. Nous