

14. Régression linéaire multiple
237
−2
−1
0
1
2
résidu standardisé
●
●
●
●
● ●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
● ●
●
●
●
●
● ●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
● ●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
● ●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
−3 −2 −1
0
1
2
3
−2
−1
0
1
2
résidu standardisé
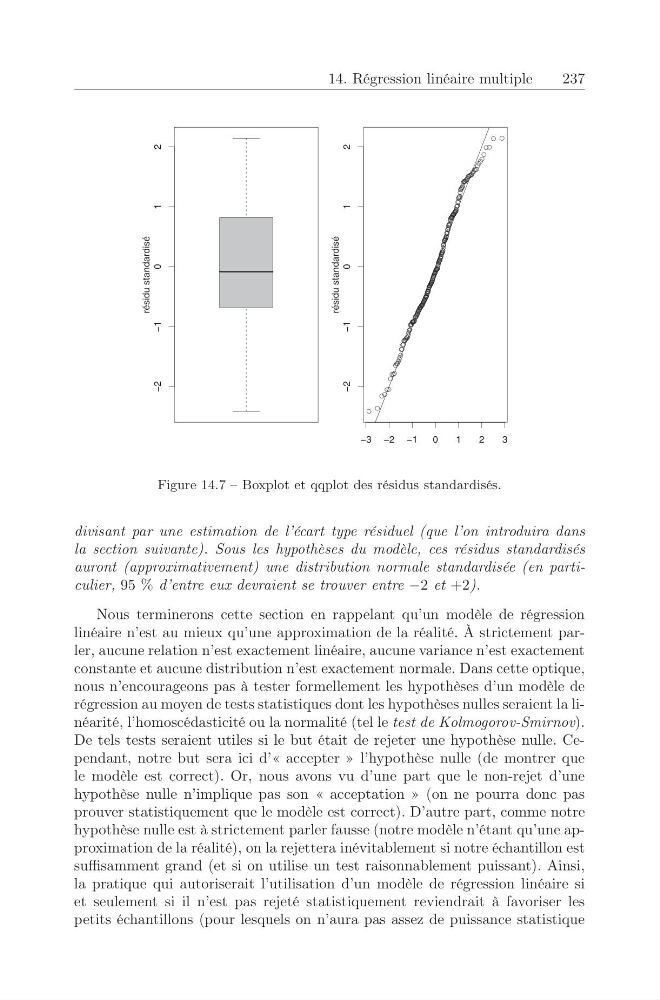
Figure 14.7 – Boxplot et qqplot des résidus standardisés.
divisant par une estimation de l’écart type résiduel (que l’on introduira dans
la section suivante). Sous les hypothèses du modèle, ces résidus standardisés
auront (approximativement) une distribution normale standardisée (en particulier, 95 % d’entre eux devraient se trouver entre −2 et +2).
Nous terminerons cette section en rappelant qu’un modèle de régression
linéaire n’est au mieux qu’une approximation de la réalité. À strictement parler, aucune relation n’est exactement linéaire, aucune variance n’est exactement
constante et aucune distribution n’est exactement normale. Dans cette optique,
nous n’encourageons pas à tester formellement les hypothèses d’un modèle de
régression au moyen de tests statistiques dont les hypothèses nulles seraient la linéarité, l’homoscédasticité ou la normalité (tel le test de Kolmogorov-Smirnov).
De tels tests seraient utiles si le but était de rejeter une hypothèse nulle. Cependant, notre but sera ici d’« accepter » l’hypothèse nulle (de montrer que
le modèle est correct). Or, nous avons vu d’une part que le non-rejet d’une
hypothèse nulle n’implique pas son « acceptation » (on ne pourra donc pas
prouver statistiquement que le modèle est correct). D’autre part, comme notre
hypothèse nulle est à strictement parler fausse (notre modèle n’étant qu’une approximation de la réalité), on la rejettera inévitablement si notre échantillon est
suffisamment grand (et si on utilise un test raisonnablement puissant). Ainsi,
la pratique qui autoriserait l’utilisation d’un modèle de régression linéaire si
et seulement si il n’est pas rejeté statistiquement reviendrait à favoriser les
petits échantillons (pour lesquels on n’aura pas assez de puissance statistique