

166
Statistique appliquée aux sciences de la vie
longueur de patte et taille de l’animal soit positive à l’intérieur de chaque espèce). Finalement, le graphique (f) nous montre un exemple de relation exacte
entre les deux variables, que l’on n’observera jamais en pratique sauf dans des
cas triviaux (par exemple lorsque l’on aura deux fois la même variable mesurée
dans des unités différentes).
12.2 Covariance
Lorsque l’on s’intéresse à la relation entre deux variables continues, la première étape d’une analyse de statistique descriptive consiste à produire un
diagramme de dispersion nous permettant de visualiser le type de relation qui
existe entre les variables. La seconde étape consiste à essayer de quantifier ce
que l’on voit. Pour ce faire, nous allons introduire les paramètres de statistique
descriptive que sont la covariance et la corrélation.
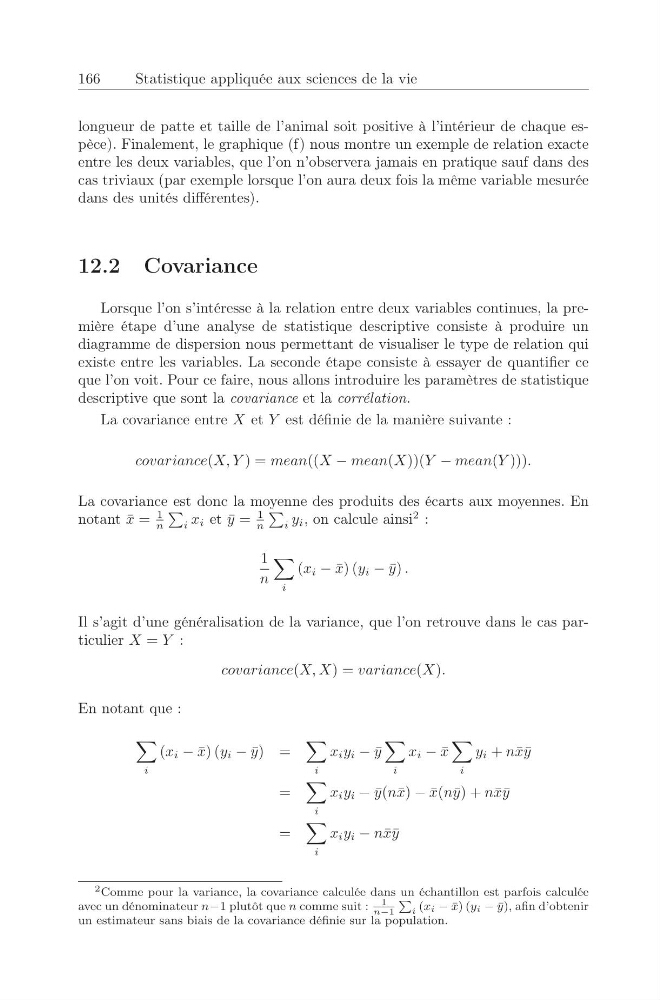
La covariance entre X et Y est définie de la manière suivante :
covariance(X, Y ) = mean((X − mean(X))(Y − mean(Y ))).
La covariance est donc la moyenne des produits des écarts aux moyennes. En
notant ¯
x =
1
n
i x i et ¯
y =
1
n
i y i , on calcule ainsi
2 :
1
n
i
(x i − ¯
x) (y i − ¯
y) .
Il s’agit d’une généralisation de la variance, que l’on retrouve dans le cas particulier X = Y :
covariance(X, X) = variance(X).
En notant que :
i
(x i − ¯
x) (y i − ¯
y) =
i
x i y i − ¯
y
i
x i − ¯
x
i
y i + n¯ x¯ y
=
i
x i y i − ¯
y(n¯ x) − ¯
x(n¯ y) + n¯ x¯ y
=
i
x i y i − n¯ x¯ y
2 Comme pour la variance, la covariance calculée dans un échantillon est parfois calculée
avec un dénominateur n−1 plutôt que n comme suit :
1
n−1
P
i (x i − ¯
x) (y i − ¯
y), afin d’obtenir
un estimateur sans biais de la covariance définie sur la population.