

11. Tests exacts avec statistique de test discrète
155
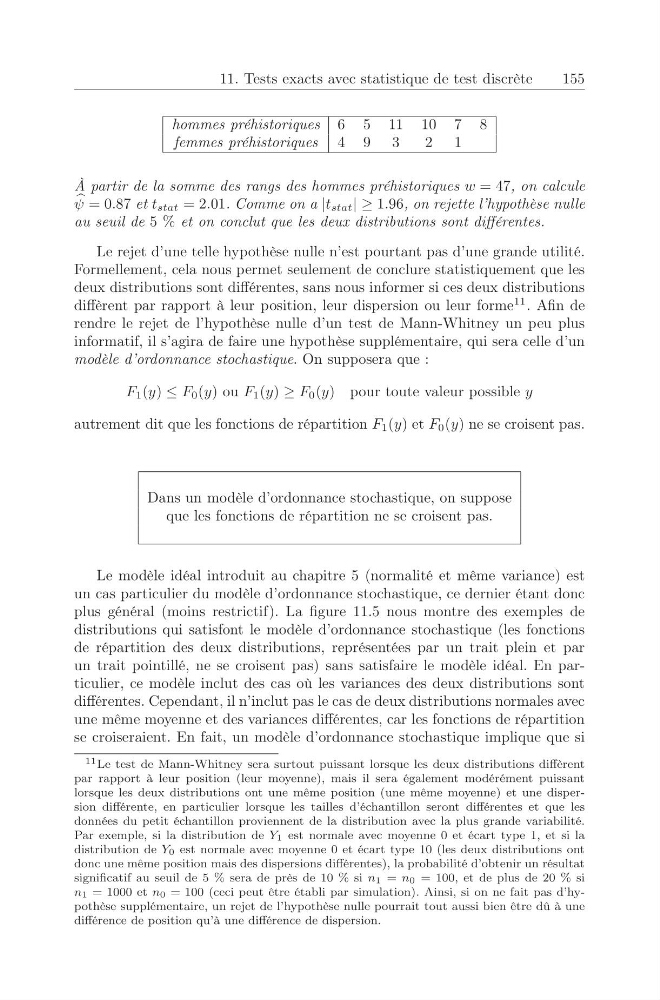
hommes préhistoriques 6 5 11 10 7 8
femmes préhistoriques 4 9 3
2 1
À partir de la somme des rangs des hommes préhistoriques w = 47, on calcule
ψ = 0.87 et t stat = 2.01. Comme on a |t stat | ≥ 1.96, on rejette l’hypothèse nulle
au seuil de 5 % et on conclut que les deux distributions sont différentes.
Le rejet d’une telle hypothèse nulle n’est pourtant pas d’une grande utilité.
Formellement, cela nous permet seulement de conclure statistiquement que les
deux distributions sont différentes, sans nous informer si ces deux distributions
diffèrent par rapport à leur position, leur dispersion ou leur forme
11 . Afin de
rendre le rejet de l’hypothèse nulle d’un test de Mann-Whitney un peu plus
informatif, il s’agira de faire une hypothèse supplémentaire, qui sera celle d’un
modèle d’ordonnance stochastique. On supposera que :
F 1 (y) ≤ F 0 (y) ou F 1 (y) ≥ F 0 (y) pour toute valeur possible y
autrement dit que les fonctions de répartition F 1 (y) et F 0 (y) ne se croisent pas.
Dans un modèle d’ordonnance stochastique, on suppose
que les fonctions de répartition ne se croisent pas.
Le modèle idéal introduit au chapitre 5 (normalité et même variance) est
un cas particulier du modèle d’ordonnance stochastique, ce dernier étant donc
plus général (moins restrictif). La figure 11.5 nous montre des exemples de
distributions qui satisfont le modèle d’ordonnance stochastique (les fonctions
de répartition des deux distributions, représentées par un trait plein et par
un trait pointillé, ne se croisent pas) sans satisfaire le modèle idéal. En particulier, ce modèle inclut des cas où les variances des deux distributions sont
différentes. Cependant, il n’inclut pas le cas de deux distributions normales avec
une même moyenne et des variances différentes, car les fonctions de répartition
se croiseraient. En fait, un modèle d’ordonnance stochastique implique que si
11 Le test de Mann-Whitney sera surtout puissant lorsque les deux distributions diffèrent
par rapport à leur position (leur moyenne), mais il sera également modérément puissant
lorsque les deux distributions ont une même position (une même moyenne) et une dispersion différente, en particulier lorsque les tailles d’échantillon seront différentes et que les
données du petit échantillon proviennent de la distribution avec la plus grande variabilité.
Par exemple, si la distribution de Y 1 est normale avec moyenne 0 et écart type 1, et si la
distribution de Y 0 est normale avec moyenne 0 et écart type 10 (les deux distributions ont
donc une même position mais des dispersions différentes), la probabilité d’obtenir un résultat
significatif au seuil de 5 % sera de près de 10 % si n 1 = n 0 = 100, et de plus de 20 % si
n 1 = 1000 et n 0 = 100 (ceci peut être établi par simulation). Ainsi, si on ne fait pas d’hypothèse supplémentaire, un rejet de l’hypothèse nulle pourrait tout aussi bien être dû à une
différence de position qu’à une différence de dispersion.