

9. Tests de Wald et de Student
125
On a ici
μ 1 = 72.6,
μ 0 = 61.6,
Δ = 11.0 et ˜
σ = 9.1. Si on effectue un test de
Student bilatéral pour une différence de moyenne (avec comme hypothèse nulle
H 0 : Δ = 0), on calcule t stat = 2.40 et p = 0.031. On rejette donc l’hypothèse
nulle au seuil de 5 %. Comme on a par ailleurs
Δ > 0, on conclut Δ > 0 (le
médicament permet d’abaisser le rythme cardiaque).
Si la seconde stratégie d’échantillonnage a été adoptée, nos deux groupes
seront constitués des mêmes n = 8 individus. Il s’agira alors d’organiser les
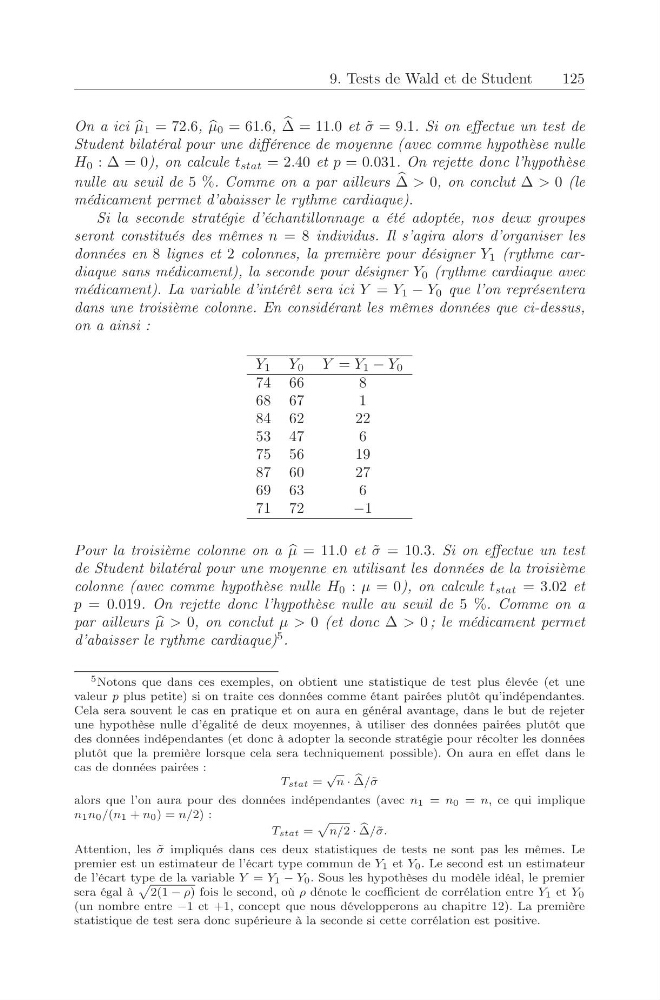
données en 8 lignes et 2 colonnes, la première pour désigner Y 1 (rythme cardiaque sans médicament), la seconde pour désigner Y 0 (rythme cardiaque avec
médicament). La variable d’intérêt sera ici Y = Y 1 − Y 0 que l’on représentera
dans une troisième colonne. En considérant les mêmes données que ci-dessus,
on a ainsi :
Y 1 Y 0 Y = Y 1 − Y 0
74 66
8
68 67
1
84 62
22
53 47
6
75 56
19
87 60
27
69 63
6
71 72
−1
Pour la troisième colonne on a
μ = 11.0 et ˜
σ = 10.3. Si on effectue un test
de Student bilatéral pour une moyenne en utilisant les données de la troisième
colonne (avec comme hypothèse nulle H 0 : μ = 0), on calcule t stat = 3.02 et
p = 0.019. On rejette donc l’hypothèse nulle au seuil de 5 %. Comme on a
par ailleurs
μ > 0, on conclut μ > 0 (et donc Δ > 0 ; le médicament permet
d’abaisser le rythme cardiaque)
5 .
5 Notons que dans ces exemples, on obtient une statistique de test plus élevée (et une
valeur p plus petite) si on traite ces données comme étant pairées plutôt qu’indépendantes.
Cela sera souvent le cas en pratique et on aura en général avantage, dans le but de rejeter
une hypothèse nulle d’égalité de deux moyennes, à utiliser des données pairées plutôt que
des données indépendantes (et donc à adopter la seconde stratégie pour récolter les données
plutôt que la première lorsque cela sera techniquement possible). On aura en effet dans le
cas de données pairées :
Tstat =
√
n · b
Δ/˜ σ
alors que l’on aura pour des données indépendantes (avec n 1 = n 0 = n, ce qui implique
n 1 n 0 /(n 1 + n 0 ) = n/2) :
Tstat =
p
n/2 · b
Δ/˜ σ.
Attention, les ˜
σ impliqués dans ces deux statistiques de tests ne sont pas les mêmes. Le
premier est un estimateur de l’écart type commun de Y 1 et Y 0 . Le second est un estimateur
de l’écart type de la variable Y = Y 1 − Y 0 . Sous les hypothèses du modèle idéal, le premier
sera égal à
p
2(1 − ρ) fois le second, où ρ dénote le coefficient de corrélation entre Y 1 et Y 0
(un nombre entre −1 et +1, concept que nous développerons au chapitre 12). La première
statistique de test sera donc supérieure à la seconde si cette corrélation est positive.