

9. Tests de Wald et de Student
121
où n 1 et n 0 représentent les tailles des échantillons,
μ 1 et
μ 0 nos estimateurs des
moyennes et ˜
σ
2
1 et ˜
σ
2
0 nos estimateurs des variances des variables en question,
et
Δ =
μ 1 −
μ 0 la différence de moyenne empirique.
Un test de Wald pour une différence de moyenne est en dualité avec un
intervalle de confiance de Wald pour cette différence de moyenne. On a vu
cependant au chapitre 5 que lorsqu’il s’agit de calculer un intervalle de confiance
pour une différence de moyenne, on préfère calculer un intervalle de confiance
de Welch, dont la validité est supérieure. Le test en dualité avec un intervalle de
confiance de Welch est appelé test de Welch. Pour effectuer ce test, on compare
la statistique de test ci-dessus non pas à une distribution normale standardisée
(comme on le ferait pour un test de Wald), mais à une distribution de Student
avec dl degrés de liberté, où dl est donné par :
dl =
˜
σ
2
1
n1 +
˜
σ
2
0
n0
2
˜
σ 4
1
n 2
1 (n1−1)
+
˜
σ 4
0
n 2
0 (n0−1)
.
Les règles de rejet de H 0 et les calculs de valeur p sont analogues à ce que
l’on a vu dans la section précédente. Un test de Welch n’est pas un test exact.
Il s’agit cependant d’un test valide si les observations sont normales ou si n 1
et n 0 sont assez grands (mêmes conditions de validité que pour l’intervalle de
confiance dual ; en particulier, on n’a pas besoin d’une hypothèse sur l’égalité
des variances σ
2
1 et σ
2
0 des deux variables).
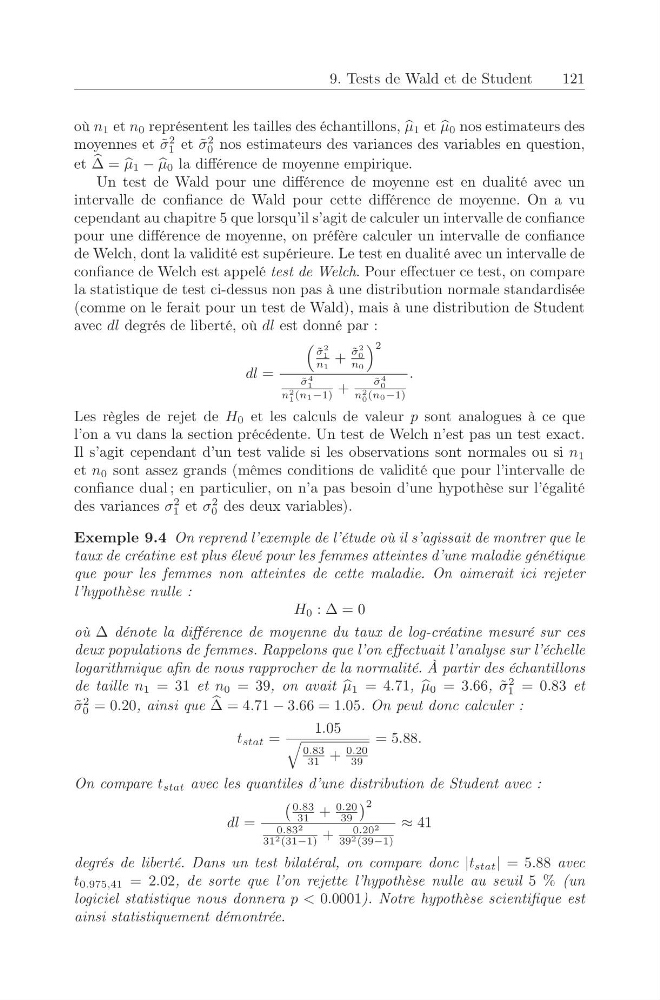
Exemple 9.4 On reprend l’exemple de l’étude où il s’agissait de montrer que le
taux de créatine est plus élevé pour les femmes atteintes d’une maladie génétique
que pour les femmes non atteintes de cette maladie. On aimerait ici rejeter
l’hypothèse nulle :
H 0 : Δ = 0
où Δ dénote la différence de moyenne du taux de log-créatine mesuré sur ces
deux populations de femmes. Rappelons que l’on effectuait l’analyse sur l’échelle
logarithmique afin de nous rapprocher de la normalité. À partir des échantillons
de taille n 1 = 31 et n 0 = 39, on avait
μ 1 = 4.71,
μ 0 = 3.66, ˜
σ
2
1 = 0.83 et
˜
σ
2
0 = 0.20, ainsi que
Δ = 4.71 − 3.66 = 1.05. On peut donc calculer :
t stat =
1.05
0.83
31 +
0.20
39
= 5.88.
On compare t stat avec les quantiles d’une distribution de Student avec :
dl =
0.83
31 +
0.20
39
2
0.83 2
31 2 (31−1) +
0.20 2
39 2 (39−1)
≈ 41
degrés de liberté. Dans un test bilatéral, on compare donc |t stat | = 5.88 avec
t 0.975,41 = 2.02, de sorte que l’on rejette l’hypothèse nulle au seuil 5 % (un
logiciel statistique nous donnera p < 0.0001). Notre hypothèse scientifique est
ainsi statistiquement démontrée.