

7. Tests du khi-deux pour tables de contingence
97
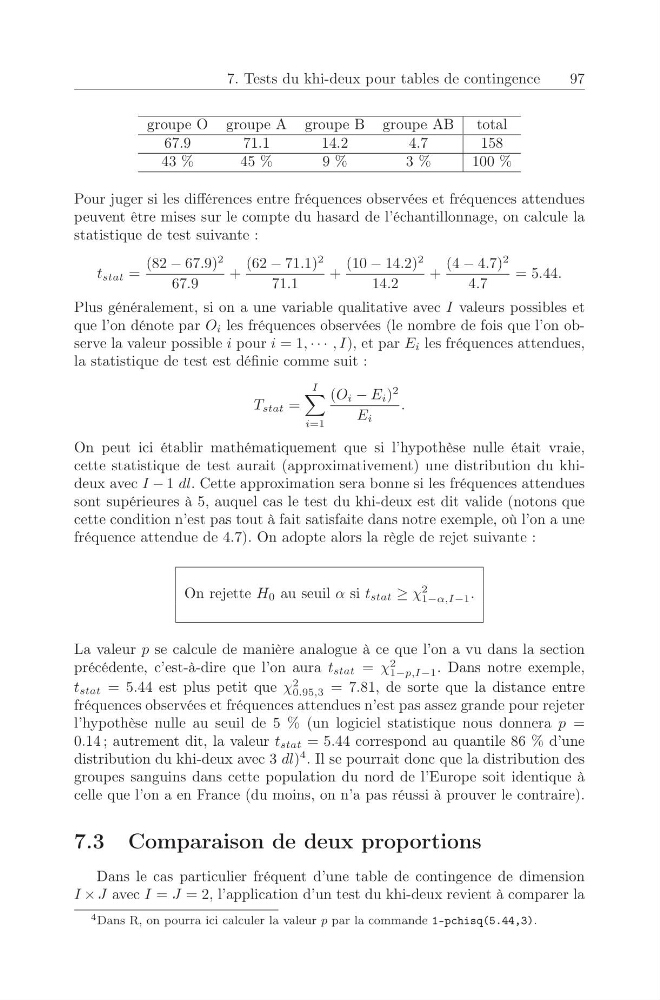
groupe O groupe A groupe B groupe AB
total
67.9
71.1
14.2
4.7
158
43 %
45 %
9 %
3 %
100 %
Pour juger si les différences entre fréquences observées et fréquences attendues
peuvent être mises sur le compte du hasard de l’échantillonnage, on calcule la
statistique de test suivante :
t stat =
(82 − 67.9)
2
67.9
+
(62 − 71.1)
2
71.1
+
(10 − 14.2)
2
14.2
+
(4 − 4.7)
2
4.7
= 5.44.
Plus généralement, si on a une variable qualitative avec I valeurs possibles et
que l’on dénote par O i les fréquences observées (le nombre de fois que l’on observe la valeur possible i pour i = 1, · · · , I), et par E i les fréquences attendues,
la statistique de test est définie comme suit :
T stat =
I
i=1
(O i − E i )
2
E i
.
On peut ici établir mathématiquement que si l’hypothèse nulle était vraie,
cette statistique de test aurait (approximativement) une distribution du khideux avec I − 1 dl. Cette approximation sera bonne si les fréquences attendues
sont supérieures à 5, auquel cas le test du khi-deux est dit valide (notons que
cette condition n’est pas tout à fait satisfaite dans notre exemple, où l’on a une
fréquence attendue de 4.7). On adopte alors la règle de rejet suivante :
On rejette H 0 au seuil α si t stat ≥ χ
2
1−α,I−1 .
La valeur p se calcule de manière analogue à ce que l’on a vu dans la section
précédente, c’est-à-dire que l’on aura t stat = χ
2
1−p,I−1 . Dans notre exemple,
t stat = 5.44 est plus petit que χ
2
0.95,3 = 7.81, de sorte que la distance entre
fréquences observées et fréquences attendues n’est pas assez grande pour rejeter
l’hypothèse nulle au seuil de 5 % (un logiciel statistique nous donnera p =
0.14 ; autrement dit, la valeur t stat = 5.44 correspond au quantile 86 % d’une
distribution du khi-deux avec 3 dl)
4 . Il se pourrait donc que la distribution des
groupes sanguins dans cette population du nord de l’Europe soit identique à
celle que l’on a en France (du moins, on n’a pas réussi à prouver le contraire).
7.3 Comparaison de deux proportions
Dans le cas particulier fréquent d’une table de contingence de dimension
I × J avec I = J = 2, l’application d’un test du khi-deux revient à comparer la
4 Dans R, on pourra ici calculer la valeur p par la commande 1-pchisq(5.44,3).