

92
Statistique appliquée aux sciences de la vie
couleur
couleur cheveux
yeux
blond
roux châtain
brun
noir
total
bleu
326
38
241
110
3
718
(45 %) (5 %) (34 %) (15 %) (0 %) (100 %)
vert
688
116
584
188
4
1580
(44 %) (7 %) (37 %) (12 %) (0 %) (100 %)
brun
343
84
909
412
26
1774
(19 %) (5 %) (51 %) (23 %) (1 %) (100 %)
noir
98
48
403
681
85
1315
(7 %) (4 %) (31 %) (52 %) (6 %) (100 %)
total
1455
286
2137
1391
118
5387
(27 %) (5 %) (40 %) (26 %) (2 %) (100 %)
On a vu que la distribution d’une variable qualitative avec J valeurs possibles
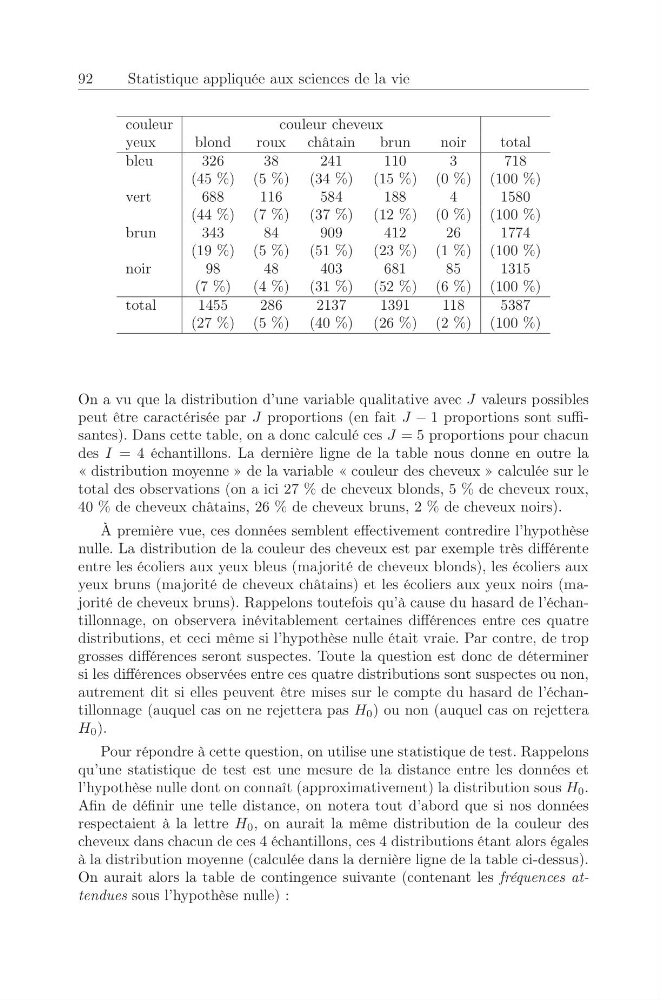
peut être caractérisée par J proportions (en fait J − 1 proportions sont suffisantes). Dans cette table, on a donc calculé ces J = 5 proportions pour chacun
des I = 4 échantillons. La dernière ligne de la table nous donne en outre la
« distribution moyenne » de la variable « couleur des cheveux » calculée sur le
total des observations (on a ici 27 % de cheveux blonds, 5 % de cheveux roux,
40 % de cheveux châtains, 26 % de cheveux bruns, 2 % de cheveux noirs).
À première vue, ces données semblent effectivement contredire l’hypothèse
nulle. La distribution de la couleur des cheveux est par exemple très différente
entre les écoliers aux yeux bleus (majorité de cheveux blonds), les écoliers aux
yeux bruns (majorité de cheveux châtains) et les écoliers aux yeux noirs (majorité de cheveux bruns). Rappelons toutefois qu’à cause du hasard de l’échantillonnage, on observera inévitablement certaines différences entre ces quatre
distributions, et ceci même si l’hypothèse nulle était vraie. Par contre, de trop
grosses différences seront suspectes. Toute la question est donc de déterminer
si les différences observées entre ces quatre distributions sont suspectes ou non,
autrement dit si elles peuvent être mises sur le compte du hasard de l’échantillonnage (auquel cas on ne rejettera pas H 0 ) ou non (auquel cas on rejettera
H 0 ).
Pour répondre à cette question, on utilise une statistique de test. Rappelons
qu’une statistique de test est une mesure de la distance entre les données et
l’hypothèse nulle dont on connaît (approximativement) la distribution sous H 0 .
Afin de définir une telle distance, on notera tout d’abord que si nos données
respectaient à la lettre H 0 , on aurait la même distribution de la couleur des
cheveux dans chacun de ces 4 échantillons, ces 4 distributions étant alors égales
à la distribution moyenne (calculée dans la dernière ligne de la table ci-dessus).
On aurait alors la table de contingence suivante (contenant les fréquences attendues sous l’hypothèse nulle) :