

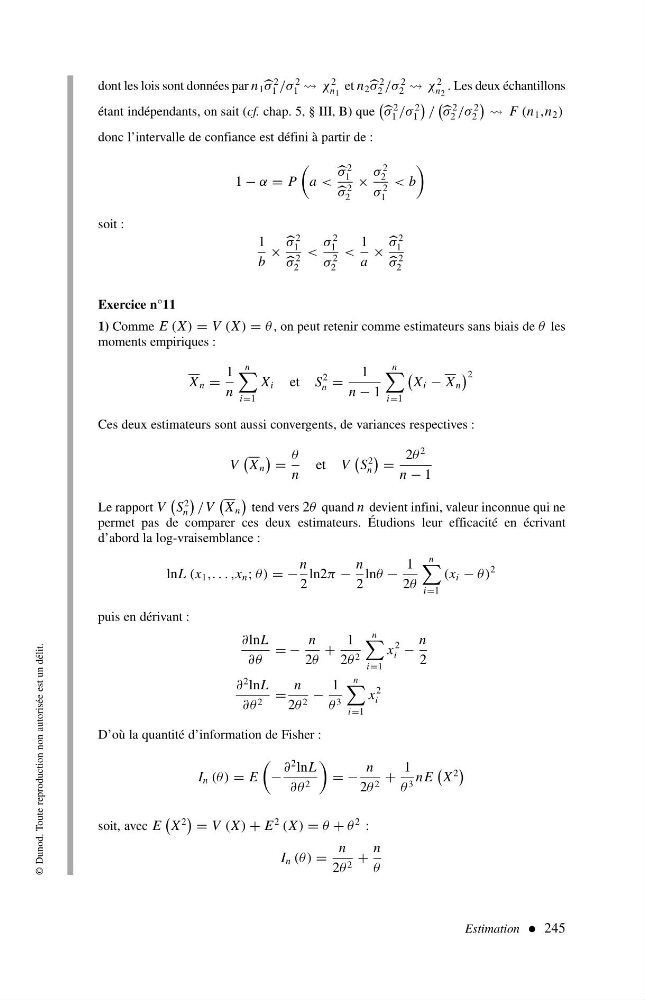
dont les lois sont données par n 1 σ
2
1 /σ
2
1 χ
2
n 1
et n 2 σ
2
2 /σ
2
2 χ
2
n 2
. Les deux échantillons
étant indépendants, on sait (cf. chap. 5, § III, B) que
σ
2
1 /σ
2
1
/
σ
2
2 /σ
2
2
F (n 1 ,n 2 )
donc l’intervalle de confiance est défini à partir de :
1 − α = P
a <
σ
2
1
σ
2
2
×
σ
2
2
σ
2
1
< b
soit :
1
b
×
σ
2
1
σ
2
2
<
σ
2
1
σ
2
2
<
1
a
×
σ
2
1
σ
2
2
Exercice n°11
1) Comme E (X) = V (X) = θ , on peut retenir comme estimateurs sans biais de θ les
moments empiriques :
X n =
1
n
n
i=1
X i et S
2
n =
1
n − 1
n
i=1
X i − X n
2
Ces deux estimateurs sont aussi convergents, de variances respectives :
V
X n
=
θ
n
et V
S
2
n
=
2θ
2
n − 1
Le rapport V
S
2
n
/V
X n
tend vers 2θ quand n devient infini, valeur inconnue qui ne
permet pas de comparer ces deux estimateurs. Étudions leur efficacité en écrivant
d’abord la log-vraisemblance :
lnL (x 1 ,...,x n ; θ) =−
n
2
ln2π −
n
2
lnθ −
1
2θ
n
i=1
(x i − θ)
2
puis en dérivant :
∂lnL
∂θ
=−
n
2θ
+
1
2θ 2
n
i =1
x
2
i −
n
2
∂
2 lnL
∂θ 2 =
n
2θ 2 −
1
θ 3
n
i =1
x
2
i
D’où la quantité d’information de Fisher :
I n (θ) = E
−
∂
2 lnL
∂θ 2
=−
n
2θ 2 +
1
θ 3 nE
X
2
soit, avec E
X
2
= V (X) + E
2 (X) = θ + θ
2 :
I n (θ) =
n
2θ 2 +
n
θ
Estimation 245
© Dunod. Toute reproduction non autorisée est un délit.
2
1 /σ
2
1 χ
2
n 1
et n 2 σ
2
2 /σ
2
2 χ
2
n 2
. Les deux échantillons
étant indépendants, on sait (cf. chap. 5, § III, B) que
σ
2
1 /σ
2
1
/
σ
2
2 /σ
2
2
F (n 1 ,n 2 )
donc l’intervalle de confiance est défini à partir de :
1 − α = P
a <
σ
2
1
σ
2
2
×
σ
2
2
σ
2
1
< b
soit :
1
b
×
σ
2
1
σ
2
2
<
σ
2
1
σ
2
2
<
1
a
×
σ
2
1
σ
2
2
Exercice n°11
1) Comme E (X) = V (X) = θ , on peut retenir comme estimateurs sans biais de θ les
moments empiriques :
X n =
1
n
n
i=1
X i et S
2
n =
1
n − 1
n
i=1
X i − X n
2
Ces deux estimateurs sont aussi convergents, de variances respectives :
V
X n
=
θ
n
et V
S
2
n
=
2θ
2
n − 1
Le rapport V
S
2
n
/V
X n
tend vers 2θ quand n devient infini, valeur inconnue qui ne
permet pas de comparer ces deux estimateurs. Étudions leur efficacité en écrivant
d’abord la log-vraisemblance :
lnL (x 1 ,...,x n ; θ) =−
n
2
ln2π −
n
2
lnθ −
1
2θ
n
i=1
(x i − θ)
2
puis en dérivant :
∂lnL
∂θ
=−
n
2θ
+
1
2θ 2
n
i =1
x
2
i −
n
2
∂
2 lnL
∂θ 2 =
n
2θ 2 −
1
θ 3
n
i =1
x
2
i
D’où la quantité d’information de Fisher :
I n (θ) = E
−
∂
2 lnL
∂θ 2
=−
n
2θ 2 +
1
θ 3 nE
X
2
soit, avec E
X
2
= V (X) + E
2 (X) = θ + θ
2 :
I n (θ) =
n
2θ 2 +
n
θ
Estimation 245
© Dunod. Toute reproduction non autorisée est un délit.