

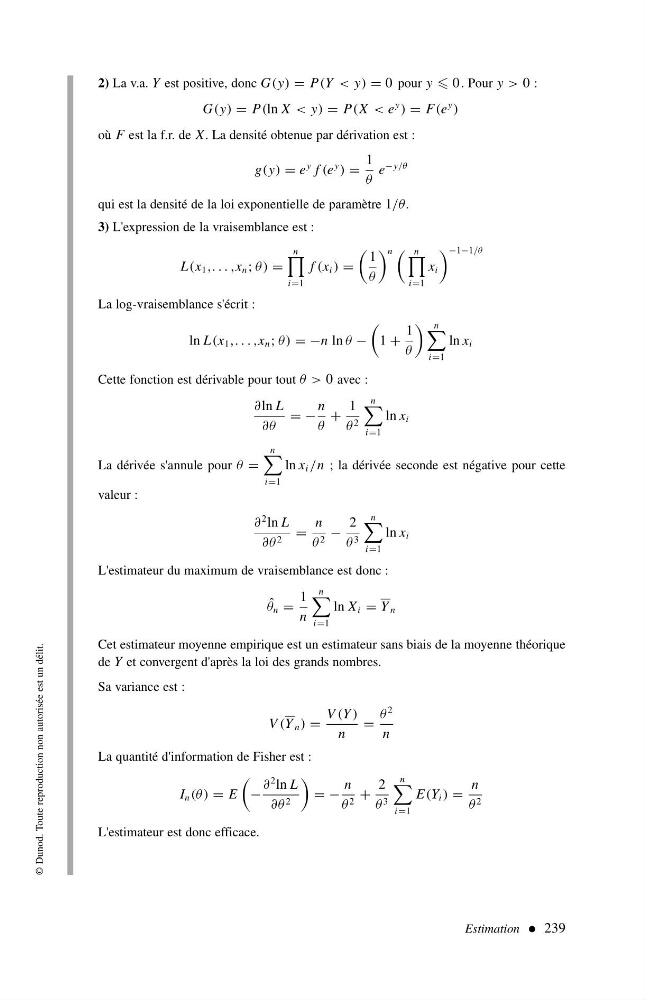
2) La v.a. Y est positive, donc G(y) = P(Y < y) = 0 pour y 0. Pour y > 0 :
G(y) = P(ln X < y) = P(X < e
y ) = F(e
y )
où F est la f.r. de X. La densité obtenue par dérivation est :
g(y) = e
y f (e
y ) =
1
θ
e
−y/θ
qui est la densité de la loi exponentielle de paramètre 1/θ.
3) L'expression de la vraisemblance est :
L(x 1 ,...,x n ; θ) =
n
i =1
f (x i ) =
1
θ
n n
i =1
x i
−1−1/θ
La log-vraisemblance s'écrit :
ln L(x 1 ,...,x n ; θ) =−n ln θ −
1 +
1
θ
n
i =1
ln x i
Cette fonction est dérivable pour tout θ>0 avec :
∂ln L
∂θ
=−
n
θ
+
1
θ 2
n
i =1
ln x i
La dérivée s'annule pour θ =
n
i =1
ln x i /n ; la dérivée seconde est négative pour cette
valeur :
∂
2 ln L
∂θ 2 =
n
θ 2 −
2
θ 3
n
i =1
ln x i
L'estimateur du maximum de vraisemblance est donc :
ˆ
θ n =
1
n
n
i =1
ln X i = Y n
Cet estimateur moyenne empirique est un estimateur sans biais de la moyenne théorique
de Y et convergent d'après la loi des grands nombres.
Sa variance est :
V (Y n ) =
V (Y )
n
=
θ
2
n
La quantité d'information de Fisher est :
I n (θ ) = E
−
∂
2 ln L
∂θ 2
=−
n
θ 2 +
2
θ 3
n
i =1
E(Y i ) =
n
θ 2
L'estimateur est donc efficace.
Estimation 239
© Dunod. Toute reproduction non autorisée est un délit.