

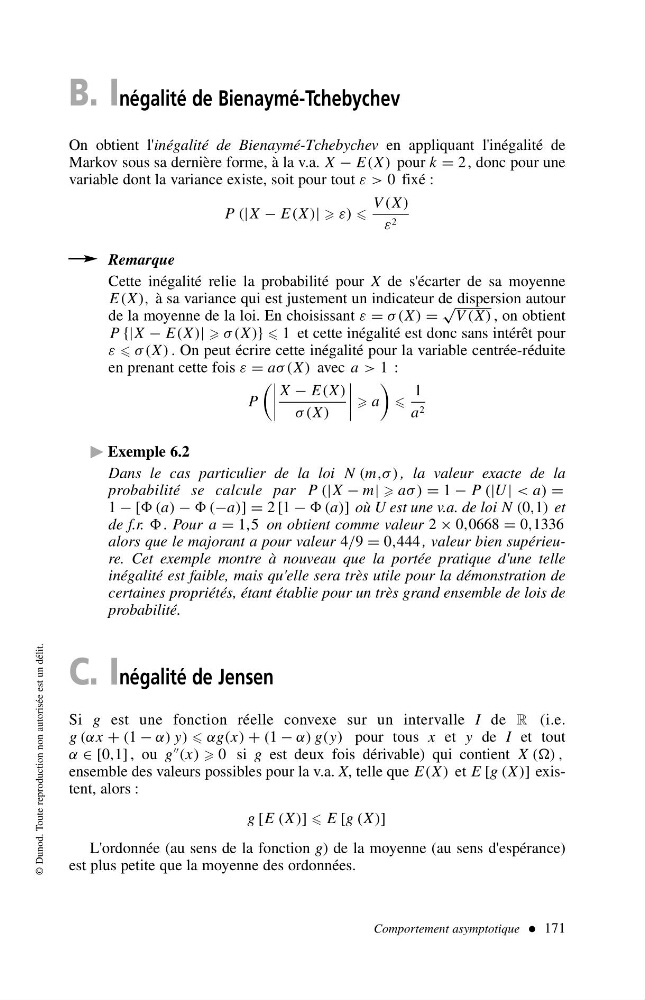
B. Inégalité de Bienaymé-Tchebychev
On obtient l'inégalité de Bienaymé-Tchebychev en appliquant l'inégalité de
Markov sous sa dernière forme, à la v.a. X − E(X) pour k = 2 , donc pour une
variable dont la variance existe, soit pour tout ε>0 fixé :
P (|X − E(X)| ε)
V (X)
ε 2
Remarque
Cette inégalité relie la probabilité pour X de s'écarter de sa moyenne
E(X), à sa variance qui est justement un indicateur de dispersion autour
de la moyenne de la loi. En choisissant ε = σ(X) =
√
V (X) , on obtient
P {|X − E(X)| σ(X)} 1 et cette inégalité est donc sans intérêt pour
ε σ(X) . On peut écrire cette inégalité pour la variable centrée-réduite
en prenant cette fois ε = aσ(X) avec a > 1:
P
X − E(X)
σ(X)
a
1
a 2
Exemple 6.2
Dans le cas particulier de la loi N (m,σ ) , la valeur exacte de la
probabilité se calcule par P (|X − m| aσ ) = 1 − P (|U | < a) =
1 − [ (a) − (−a)] = 2 [1 − (a)] où U est une v.a. de loi N (0,1) et
de f.r. . Pour a = 1,5 on obtient comme valeur 2 × 0,0668 = 0,1336
alors que le majorant a pour valeur 4/9 = 0,444 , valeur bien supérieure. Cet exemple montre à nouveau que la portée pratique d'une telle
inégalité est faible, mais qu'elle sera très utile pour la démonstration de
certaines propriétés, étant établie pour un très grand ensemble de lois de
probabilité.
C. Inégalité de Jensen
Si g est une fonction réelle convexe sur un intervalle I de R (i.e.
g (αx + (1 − α) y) αg(x) + (1 − α) g(y) pour tous x et y de I et tout
α ∈ [0,1] , ou g
′′ (x) 0 si g est deux fois dérivable) qui contient X () ,
ensemble des valeurs possibles pour la v.a. X, telle que E(X) et E [g (X)] existent, alors :
g [E (X)] E [g (X)]
L'ordonnée (au sens de la fonction g) de la moyenne (au sens d'espérance)
est plus petite que la moyenne des ordonnées.
Comportement asymptotique 171
© Dunod. Toute reproduction non autorisée est un délit.