

CHAPITRE VI Application du Machine Learning pour l’étude du franchissement
99
VI.2.6.1.3
Apprentissage :
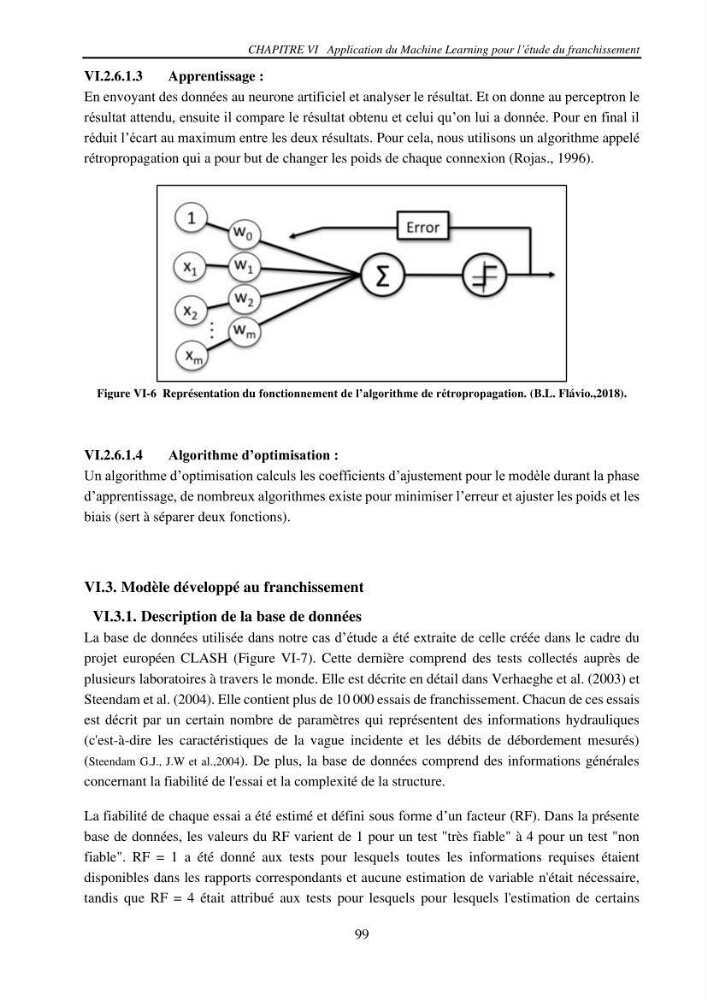
En envoyant des données au neurone artificiel et analyser le résultat. Et on donne au perceptron le
résultat attendu, ensuite il compare le résultat obtenu et celui qu’on lui a donnée. Pour en final il
réduit l’écart au maximum entre les deux résultats. Pour cela, nous utilisons un algorithme appelé
rétropropagation qui a pour but de changer les poids de chaque connexion (Rojas., 1996).
Figure VI-6 Représentation du fonctionnement de l’algorithme de rétropropagation. (B.L. Flávio.,2018).
VI.2.6.1.4
Algorithme d’optimisation :
Un algorithme d’optimisation calculs les coefficients d’ajustement pour le modèle durant la phase
d’apprentissage, de nombreux algorithmes existe pour minimiser l’erreur et ajuster les poids et les
biais (sert à séparer deux fonctions).
VI.3. Modèle développé au franchissement
VI.3.1. Description de la base de données
La base de données utilisée dans notre cas d’étude a été extraite de celle créée dans le cadre du
projet européen CLASH (Figure VI-7). Cette dernière comprend des tests collectés auprès de
plusieurs laboratoires à travers le monde. Elle est décrite en détail dans Verhaeghe et al. (2003) et
Steendam et al. (2004). Elle contient plus de 10 000 essais de franchissement. Chacun de ces essais
est décrit par un certain nombre de paramètres qui représentent des informations hydrauliques
(c'est-à-dire les caractéristiques de la vague incidente et les débits de débordement mesurés)
(Steendam G.J., J.W et al.,2004). De plus, la base de données comprend des informations générales
concernant la fiabilité de l'essai et la complexité de la structure.
La fiabilité de chaque essai a été estimé et défini sous forme d’un facteur (RF). Dans la présente
base de données, les valeurs du RF varient de 1 pour un test "très fiable" à 4 pour un test "non
fiable". RF = 1 a été donné aux tests pour lesquels toutes les informations requises étaient
disponibles dans les rapports correspondants et aucune estimation de variable n'était nécessaire,
tandis que RF = 4 était attribué aux tests pour lesquels pour lesquels l'estimation de certains