

CHAPITRE VI Application du Machine Learning pour l’étude du franchissement
94
Avec une fonction de coût de type quadratique (moyenne des erreurs quadratique MSE), on obtient
la solution de maximum de vraisemblance quand le bruit est gaussien ou normalement distribué.
Mais, la présence d’une valeur aberrante risque de biaiser le modèle obtenu représenté par la
fonction f. L’idée qui permet de généraliser l’utilisation des SVMs de la classification à la
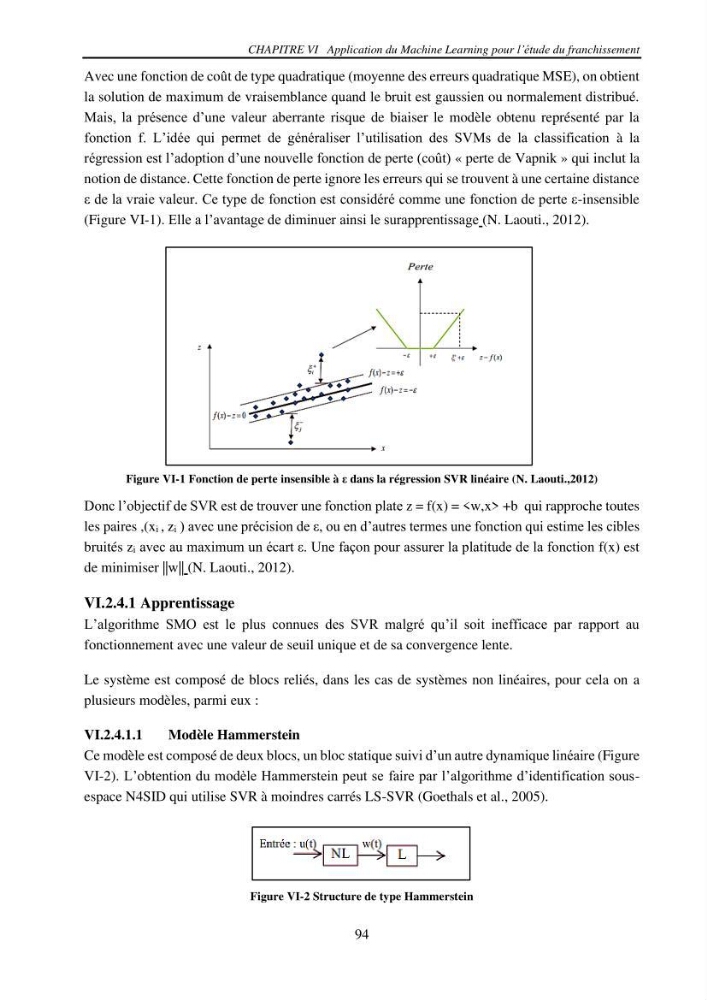
régression est l’adoption d’une nouvelle fonction de perte (coût) « perte de Vapnik » qui inclut la
notion de distance. Cette fonction de perte ignore les erreurs qui se trouvent à une certaine distance
ε de la vraie valeur. Ce type de fonction est considéré comme une fonction de perte ε-insensible
(Figure VI-1). Elle a l’avantage de diminuer ainsi le surapprentissage (N. Laouti., 2012).
Figure VI-1 Fonction de perte insensible à ε dans la régression SVR linéaire (N. Laouti.,2012)
Donc l’objectif de SVR est de trouver une fonction plate z = f(x) = +b qui rapproche toutes
les paires ,(xi , zi ) avec une précision de ε, ou en d’autres termes une fonction qui estime les cibles
bruités zi avec au maximum un écart ε. Une façon pour assurer la platitude de la fonction f(x) est
de minimiser ||w|| (N. Laouti., 2012).
VI.2.4.1 Apprentissage
L’algorithme SMO est le plus connues des SVR malgré qu’il soit inefficace par rapport au
fonctionnement avec une valeur de seuil unique et de sa convergence lente.
Le système est composé de blocs reliés, dans les cas de systèmes non linéaires, pour cela on a
plusieurs modèles, parmi eux :
VI.2.4.1.1
Modèle Hammerstein
Ce modèle est composé de deux blocs, un bloc statique suivi d’un autre dynamique linéaire (Figure
VI-2). L’obtention du modèle Hammerstein peut se faire par l’algorithme d’identification sousespace N4SID qui utilise SVR à moindres carrés LS-SVR (Goethals et al., 2005).
Figure VI-2 Structure de type Hammerstein
94
Avec une fonction de coût de type quadratique (moyenne des erreurs quadratique MSE), on obtient
la solution de maximum de vraisemblance quand le bruit est gaussien ou normalement distribué.
Mais, la présence d’une valeur aberrante risque de biaiser le modèle obtenu représenté par la
fonction f. L’idée qui permet de généraliser l’utilisation des SVMs de la classification à la
régression est l’adoption d’une nouvelle fonction de perte (coût) « perte de Vapnik » qui inclut la
notion de distance. Cette fonction de perte ignore les erreurs qui se trouvent à une certaine distance
ε de la vraie valeur. Ce type de fonction est considéré comme une fonction de perte ε-insensible
(Figure VI-1). Elle a l’avantage de diminuer ainsi le surapprentissage (N. Laouti., 2012).
Figure VI-1 Fonction de perte insensible à ε dans la régression SVR linéaire (N. Laouti.,2012)
Donc l’objectif de SVR est de trouver une fonction plate z = f(x) =
les paires ,(xi , zi ) avec une précision de ε, ou en d’autres termes une fonction qui estime les cibles
bruités zi avec au maximum un écart ε. Une façon pour assurer la platitude de la fonction f(x) est
de minimiser ||w|| (N. Laouti., 2012).
VI.2.4.1 Apprentissage
L’algorithme SMO est le plus connues des SVR malgré qu’il soit inefficace par rapport au
fonctionnement avec une valeur de seuil unique et de sa convergence lente.
Le système est composé de blocs reliés, dans les cas de systèmes non linéaires, pour cela on a
plusieurs modèles, parmi eux :
VI.2.4.1.1
Modèle Hammerstein
Ce modèle est composé de deux blocs, un bloc statique suivi d’un autre dynamique linéaire (Figure
VI-2). L’obtention du modèle Hammerstein peut se faire par l’algorithme d’identification sousespace N4SID qui utilise SVR à moindres carrés LS-SVR (Goethals et al., 2005).
Figure VI-2 Structure de type Hammerstein