

CHAPITRE VI Application du Machine Learning pour l’étude du franchissement
93
La détermination du modèle revient alors à calculer les paramètres. Cela se fait en réduisant
l’erreur quadratique moyenne (MSE). La solution s’obtient à l’aide de manipulations matricielles.
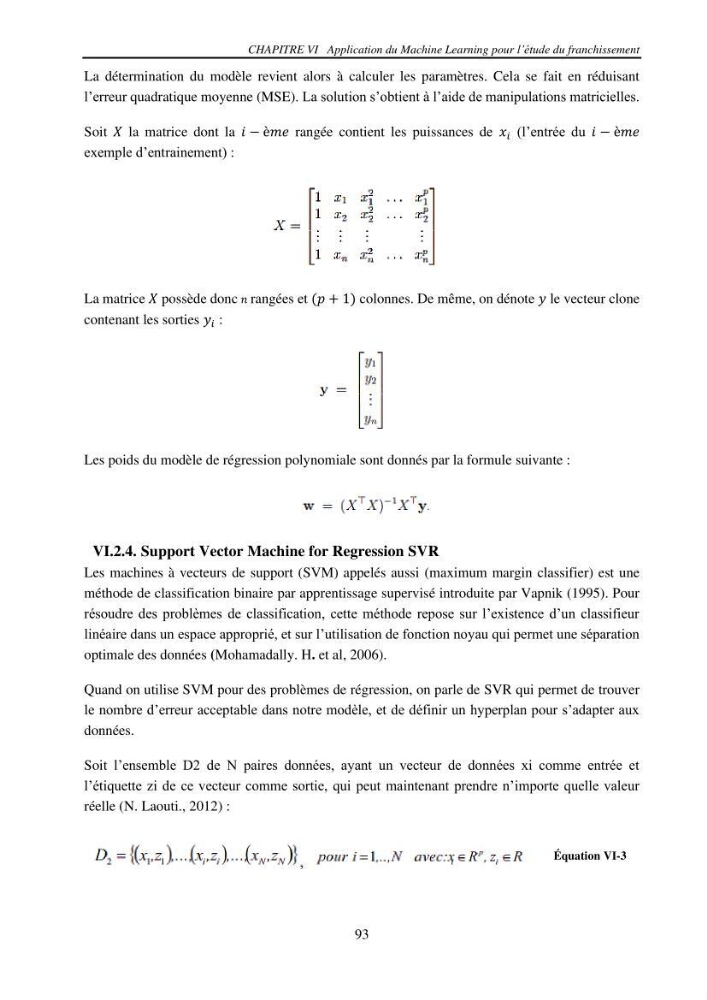
Soit í µí± la matrice dont la í µí± − èí µí±í µí± rangée contient les puissances de í µí±¥ í µí± (l’entrée du í µí± − èí µí±í µí±
exemple d’entrainement) :
La matrice í µí± possède donc í µí± rangées et (í µí± + 1) colonnes. De même, on dénote í µí±¦ le vecteur clone
contenant les sorties í µí±¦ í µí± :
Les poids du modèle de régression polynomiale sont donnés par la formule suivante :
VI.2.4. Support Vector Machine for Regression SVR
Les machines à vecteurs de support (SVM) appelés aussi (maximum margin classifier) est une
méthode de classification binaire par apprentissage supervisé introduite par Vapnik (1995). Pour
résoudre des problèmes de classification, cette méthode repose sur l’existence d’un classifieur
linéaire dans un espace approprié, et sur l’utilisation de fonction noyau qui permet une séparation
optimale des données (Mohamadally. H. et al, 2006).
Quand on utilise SVM pour des problèmes de régression, on parle de SVR qui permet de trouver
le nombre d’erreur acceptable dans notre modèle, et de définir un hyperplan pour s’adapter aux
données.
Soit l’ensemble D2 de N paires données, ayant un vecteur de données xi comme entrée et
l’étiquette zi de ce vecteur comme sortie, qui peut maintenant prendre n’importe quelle valeur
réelle (N. Laouti., 2012) :
Équation VI-3