

chapitre 26 La phylogenèse et l’arbre de la vie 625
L’évaluation des homologies moléculaires
Les comparaisons de molécules d’ADN posent certains défis
techniques. La première étape, après le séquençage des molécules, consiste à aligner les séquences homologues issues des
espèces comparées. Si ces dernières ont divergé d’un même
ancêtre relativement récent, les séquences ne diffèrent probablement que par une ou quelques bases. Par contre, chez les
espèces moins proches, les séquences d’ADN homologues différeront probablement à la fois par les bases de certains sites
et par la longueur totale des séquences. Ces différences s’expliquent par le fait que l’accumulation des mutations au fil
du temps (notamment les insertions et les délétions) risque
fort de modifier la longueur des gènes.
Imaginons, par exemple, que deux séquences d’ADN
issues de deux espèces soient très semblables, mais qu’une
délétion ait supprimé la première base de la séquence provenant de l’une de ces deux espèces. Il s’ensuivrait un décalage de tous les autres nucléotides ; une comparaison point
par point des deux séquences étudiées aboutirait à une conclusion erronée. On pourrait, en effet, croire à une différence
marquée entre elles, alors qu’en fait il y aurait une concordance générale. Pour surmonter ce type de problèmes, des
chercheurs ont mis au point des logiciels qui déterminent la
meilleure façon d’aligner les segments d’ADN homologues
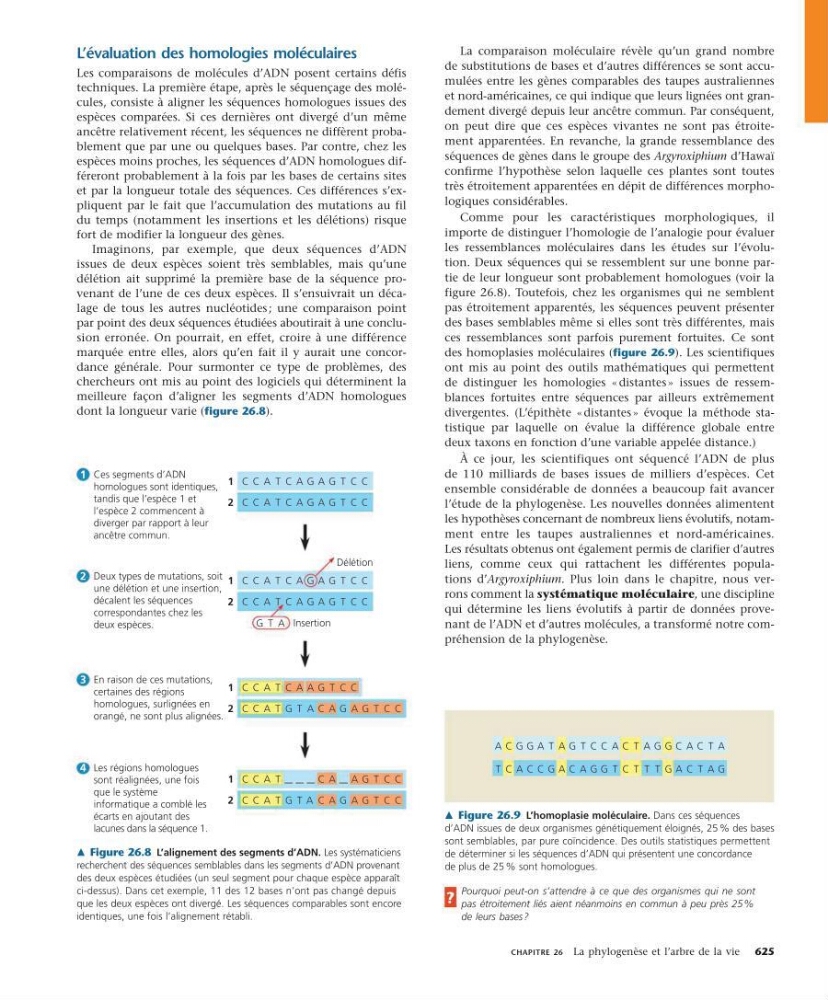
dont la longueur varie (figure 26.8).
La comparaison moléculaire révèle qu’un grand nombre
de substitutions de bases et d’autres différences se sont accumulées entre les gènes comparables des taupes australiennes
et nord-américaines, ce qui indique que leurs lignées ont grandement divergé depuis leur ancêtre commun. Par conséquent,
on peut dire que ces espèces vivantes ne sont pas étroitement apparentées. En revanche, la grande ressemblance des
séquences de gènes dans le groupe des Argyroxiphium d’Hawaï
confirme l’hypothèse selon laquelle ces plantes sont toutes
très étroitement apparentées en dépit de différences morpholo giques considérables.
Comme pour les caractéristiques morphologiques, il
importe de distinguer l’homologie de l’analogie pour évaluer
les ressemblances moléculaires dans les études sur l’évolution. Deux séquences qui se ressemblent sur une bonne partie de leur longueur sont probablement homologues (voir la
figure 26.8). Toutefois, chez les organismes qui ne semblent
pas étroitement apparentés, les séquences peuvent présenter
des bases semblables même si elles sont très différentes, mais
ces ressemblances sont parfois purement fortuites. Ce sont
des homoplasies moléculaires (figure 26.9). Les scientifiques
ont mis au point des outils mathématiques qui permettent
de distinguer les homologies « distantes » issues de ressemblances fortuites entre séquences par ailleurs extrêmement
divergentes. (L’épithète « distantes » évoque la méthode statistique par laquelle on évalue la différence globale entre
deux taxons en fonction d’une variable appelée distance.)
À ce jour, les scientifiques ont séquencé l’ADN de plus
de 110 milliards de bases issues de milliers d’espèces. Cet
ensemble considérable de données a beaucoup fait avancer
l’étude de la phylogenèse. Les nouvelles données alimentent
les hypothèses concernant de nombreux liens évolutifs, notamment entre les taupes australiennes et nord-américaines.
Les résultats obtenus ont également permis de clarifier d’autres
liens, comme ceux qui rattachent les différentes populations d’Argyroxiphium. Plus loin dans le chapitre, nous verrons comment la systématique moléculaire, une discipline
qui détermine les liens évolutifs à partir de données provenant de l’ADN et d’autres molécules, a transformé notre compréhension de la phylogenèse.
m Figure 26.8 L’alignement des segments d’ADN. Les systématiciens
recherchent des séquences semblables dans les segments d’ADN provenant
des deux espèces étudiées (un seul segment pour chaque espèce apparaît
ci-dessus). Dans cet exemple, 11 des 12 bases n’ont pas changé depuis
que les deux espèces ont divergé. Les séquences comparables sont encore
identiques, une fois l’alignement rétabli.
C C A T C A G A G T C C
C C A T C A G A G T C C
1
2
C
Délétion
Insertion
C A T C A G A G T C C
C C A T
G T A
C A G A G T C C
1
2
C C A T C A A G T C C
C C A T G T A C A G A G T C C
1
2
C C A T
C A
A G T C C
C C A T G T A C A G A G T C C
1
2
Ces segments d’ADN
homologues sont identiques,
tandis que l’espèce 1 et
l’espèce 2 commencent à
diverger par rapport à leur
ancêtre commun.
1
Deux types de mutations, soit
une délétion et une insertion,
décalent les séquences
correspondantes chez les
deux espèces.
2
En raison de ces mutations,
certaines des régions
homologues, surlignées en
orangé, ne sont plus alignées.
3
Les régions homologues
sont réalignées, une fois
que le système
informatique a comblé les
écarts en ajoutant des
lacunes dans la séquence 1.
4
m Figure 26.9 L’homoplasie moléculaire. Dans ces séquences
d’ADN issues de deux organismes génétiquement éloignés, 25 % des bases
sont semblables, par pure coïncidence. Des outils statistiques permettent
de déterminer si les séquences d’ADN qui présentent une concordance
de plus de 25 % sont homologues.
Pourquoi peut-on s’attendre à ce que des organismes qui ne sont
pas étroitement liés aient néanmoins en commun à peu près 25 %
de leurs bases ?
?
A C G G A T A G T C C A C T A G G C A C T A
T C A C C G A C A G G T C T T T G A C T A G