

chapitre 5 Structure et fonction des molécules organiques complexes 95
l’ADN. Cependant, l’ADN ne participe pas directement aux
opérations de la cellule, pas plus qu’un logiciel ne peut imprimer un texte scientifique ou lire un code à barres sur une
boîte de céréales. Tout comme il faut une imprimante pour
imprimer un texte ou un lecteur pour lire un code à barres,
il faut des protéines pour exécuter les programmes génétiques.
Les protéines sont à la cellule ce que le matériel informatique
est à l’ordinateur. Par exemple, c’est l’hémoglobine, une
protéine, et non l’ADN qui transporte le dioxygène dans les
globules rouges du sang ; l’ADN, lui, spécifie la structure de
l’hémoglobine.
Comment l’ARN, l’autre sorte d’acide nucléique, sert-il
d’intermédiaire dans l’expression génique, la circulation de
l’information génétique de l’ADN aux protéines ? Chaque
gène présent sur la molécule d’ADN dirige la synthèse d’un
type d’ARN appelé ARN messager (ARNm). La molécule d’ARNm
interagit avec le mécanisme de la synthèse protéique pour
diriger la production d’un polypeptide qui se replie pour
former une protéine complète ou une partie de protéine.
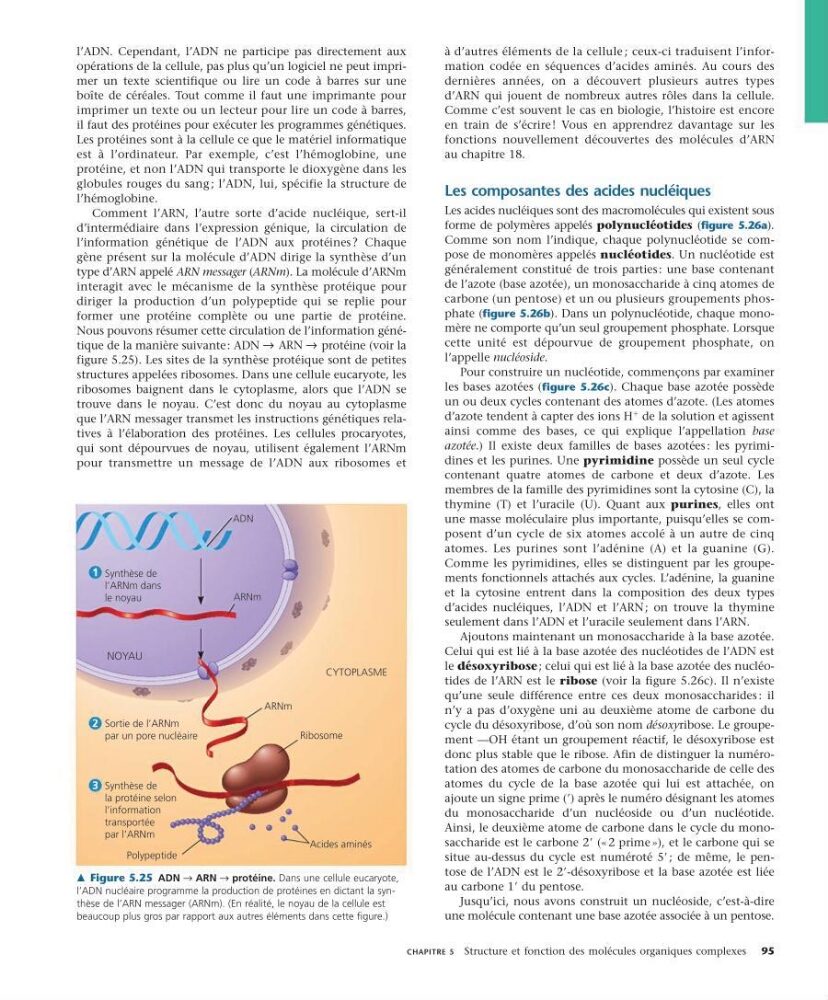
Nous pouvons résumer cette circulation de l’information génétique de la manière suivante : ADN → ARN → protéine (voir la
figure 5.25). Les sites de la synthèse protéique sont de petites
structures appelées ribosomes. Dans une cellule eucaryote, les
ribosomes baignent dans le cytoplasme, alors que l’ADN se
trouve dans le noyau. C’est donc du noyau au cytoplasme
que l’ARN messager transmet les instructions génétiques relatives à l’élaboration des protéines. Les cellules procaryotes,
qui sont dépourvues de noyau, utilisent également l’ARNm
pour transmettre un message de l’ADN aux ribosomes et
à d’autres éléments de la cellule ; ceux-ci traduisent l’information codée en séquences d’acides aminés. Au cours des
dernières années, on a découvert plusieurs autres types
d’ARN qui jouent de nombreux autres rôles dans la cellule.
Comme c’est souvent le cas en biologie, l’histoire est encore
en train de s’écrire ! Vous en apprendrez davantage sur les
fonctions nouvellement découvertes des molécules d’ARN
au chapitre 18.
Les composantes des acides nucléiques
Les acides nucléiques sont des macromolécules qui existent sous
forme de polymères appelés polynucléotides (figure 5.26a).
Comme son nom l’indique, chaque polynucléotide se compose de monomères appelés nucléotides. Un nucléotide est
généralement constitué de trois parties : une base contenant
de l’azote (base azotée), un monosaccharide à cinq atomes de
carbone (un pentose) et un ou plusieurs groupements phosphate (figure 5.26b). Dans un polynucléotide, chaque monomère ne comporte qu’un seul groupement phosphate. Lorsque
cette unité est dépourvue de groupement phosphate, on
l’appelle nucléoside.
Pour construire un nucléotide, commençons par examiner
les bases azotées (figure 5.26c). Chaque base azotée possède
un ou deux cycles contenant des atomes d’azote. (Les atomes
d’azote tendent à capter des ions H
1
de la solution et agissent
ainsi comme des bases, ce qui explique l’appellation base
azotée.) Il existe deux familles de bases azotées : les pyrimidines et les purines. Une pyrimidine possède un seul cycle
contenant quatre atomes de carbone et deux d’azote. Les
membres de la famille des pyrimidines sont la cytosine (C), la
thymine (T) et l’uracile (U). Quant aux purines, elles ont
une masse moléculaire plus importante, puisqu’elles se composent d’un cycle de six atomes accolé à un autre de cinq
atomes. Les purines sont l’adénine (A) et la guanine (G).
Comme les pyrimidines, elles se distinguent par les groupements fonctionnels attachés aux cycles. L’adénine, la guanine
et la cytosine entrent dans la composition des deux types
d’acides nucléiques, l’ADN et l’ARN ; on trouve la thymine
seulement dans l’ADN et l’uracile seulement dans l’ARN.
Ajoutons maintenant un monosaccharide à la base azotée.
Celui qui est lié à la base azotée des nucléotides de l’ADN est
le désoxyribose ; celui qui est lié à la base azotée des nucléotides de l’ARN est le ribose (voir la figure 5.26c). Il n’existe
qu’une seule différence entre ces deux monosaccharides : il
n’y a pas d’oxygène uni au deuxième atome de carbone du
cycle du désoxyribose, d’où son nom désoxyribose. Le groupement —OH étant un groupement réactif, le désoxyribose est
donc plus stable que le ribose. Afin de distinguer la numérotation des atomes de carbone du monosaccharide de celle des
atomes du cycle de la base azotée qui lui est attachée, on
ajoute un signe prime (9) après le numéro désignant les atomes
du monosaccharide d’un nucléoside ou d’un nucléotide.
Ainsi, le deuxième atome de carbone dans le cycle du monosaccharide est le carbone 29 (« 2 prime »), et le carbone qui se
situe au-dessus du cycle est numéroté 59 ; de même, le pentose de l’ADN est le 29-désoxyribose et la base azotée est liée
au carbone 19 du pentose.
Jusqu’ici, nous avons construit un nucléoside, c’est-à-dire
une molécule contenant une base azotée associée à un pentose.
m Figure 5.25 ADN → ARN → protéine. Dans une cellule eucaryote,
l’ADN nucléaire programme la production de protéines en dictant la synthèse de l’ARN messager (ARNm). (En réalité, le noyau de la cellule est
beaucoup plus gros par rapport aux autres éléments dans cette figure.)
1
ARNm
Ribosome
Acides aminés
Polypeptide
CYTOPLASME
ADN
ARNm
NOYAU
Synthèse de
l’ARNm dans
le noyau
1
Sortie de l’ARNm
par un pore nucléaire
2
Synthèse de
la protéine selon
l’information
transportée
par l’ARNm
3