

300
11 Ouvertures
Typiquement, l’entier N b (taille de la base d’orbitales atomiques) est de l’ordre
de m × N (N désigne le nombre d’électrons) pour un entier m compris entre
2 et 10.
L’approche directe pour résoudre (11.1), ou de façon équivalente (11.2),
consiste à diagonaliser F , ou plus précisément à résoudre le problème aux
valeurs propres généralisé F Φ = et à collecter les N vecteurs propres
associés aux N plus petites valeurs propres de ce problème. La complexité
algorithmique de cette approche est donc de l’ordre de N
3
b (voir par
exemple [79]).
Pour les systèmes moléculaires de grande taille, ce coût de calcul est prohibitif.
Fort heureusement, d’autres approches basées sur les trois remarques suivantes
permettent de réduire cette complexité algorithmique :
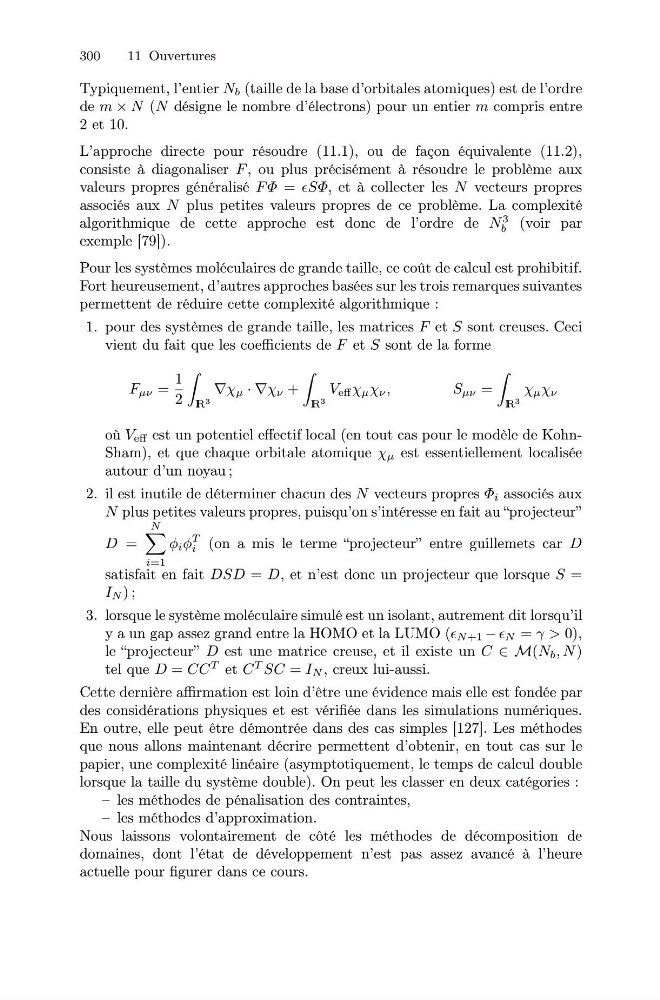
1. pour des systèmes de grande taille, les matrices F et S sont creuses. Ceci
vient du fait que les coefficients de F et S sont de la forme
F µν =
1
2
I R 3
∇χ µ · ∇χ ν +
I R 3
V eff χ µ χ ν ,
S µν =
I R 3
χ µ χ ν
où V eff est un potentiel effectif local (en tout cas pour le modèle de KohnSham), et que chaque orbitale atomique χ µ est essentiellement localisée
autour d’un noyau ;
2. il est inutile de déterminer chacun des N vecteurs propres Φ i associés aux
N plus petites valeurs propres, puisqu’on s’intéresse en fait au “projecteur”
D =
N
i=1
φ i φ
T
i (on a mis le terme “projecteur” entre guillemets car D
satisfait en fait DSD = D, et n’est donc un projecteur que lorsque S =
I N ) ;
3. lorsque le système moléculaire simulé est un isolant, autrement dit lorsqu’il
y a un gap assez grand entre la HOMO et la LUMO ( N +1 − N = γ > 0),
le “projecteur” D est une matrice creuse, et il existe un C ∈ M(N b , N)
tel que D = CC
T et C
T SC = I N , creux lui-aussi.
Cette dernière affirmation est loin d’être une évidence mais elle est fondée par
des considérations physiques et est vérifiée dans les simulations numériques.
En outre, elle peut être démontrée dans des cas simples [127]. Les méthodes
que nous allons maintenant décrire permettent d’obtenir, en tout cas sur le
papier, une complexité linéaire (asymptotiquement, le temps de calcul double
lorsque la taille du système double). On peut les classer en deux catégories :
– les méthodes de pénalisation des contraintes,
– les méthodes d’approximation.
Nous laissons volontairement de côté les méthodes de décomposition de
domaines, dont l’état de développement n’est pas assez avancé à l’heure
actuelle pour figurer dans ce cours.