

4. F LUX DE L ’ INFORMATION GÉNÉTIQUE.S TRUCTURE ET EXPRESSION DES G È NES.
81
© Dunod – La photocopie non autorisée est un délit.
obtenue dans un système acellulaire simple,
dérivé d’un homogénat de cellules de foie ; celui-ci
contient seulement un extrait de protéines et
d’ARN solubles, des ribosomes purifiés, de l’ATP
et des ions Mg
2+
. Dans ce système biochimique
reconstitué, des acides aminés radioactifs sont
incorporés dans des protéines. Ce type d’observation fut rapidement généralisé à d’autres types cellulaires eucaryotiques, ainsi qu’aux Procaryotes.
Le composant majeur du système étant constitué
par les ribosomes, on a d’abord cru qu’ils étaient
différents les uns des autres et qu’ils portaient euxmêmes l’information génétique correspondant aux
protéines dont ils assuraient la synthèse. Il fut
cependant vite démontré que ces particules étaient
toutes identiques dans les cellules, contenant en
particulier les mêmes ARN (ARNr), et qu’elles ne
pouvaient donc pas constituer le message spécifiant les protéines. Cette constatation posait donc
la question de l’origine et de la nature de l’espèce
moléculaire responsable de cette spécificité ; la
découverte des ARNm chez les Procaryotes, à la
fin de la décennie, apportait la réponse.
Des expériences de marquage court ( pulse ; voir
chapitre 3), par des précurseurs radioactifs de protéines, de cellules telles que des réticulocytes (qui
fabriquent abondamment une seule protéine : la
globine), ont conduit à identifier le lieu exact de la
polymérisation des acides aminés au sein du hyaloplasme. Grâce à la technique de centrifugation
en gradient de saccharose, il est démontré que les
protéines naissantes sont associées à des ribosomes assemblés en chapelets ( polysomes), et
réunis par une longue molécule d’ARN (A. Rich,
1963). La microscopie électronique permet de
visualiser ces structures qui participent à la synthèse protéique ; l’intervention de l’ARNm est ainsi
confirmée de manière directe chez les Eucaryotes.
2.4. Déchiffrage du code génétique
La question du passage d’un alphabet de
quatre lettres (celui des acides nucléiques) à un
alphabet de vingt lettres (dans les protéines) est
celle du code génétique, c’est-à-dire du système
de correspondance formelle existant entre les deux
catégories de séquences. Des considérations
mathématiques simples conduisent à l’idée qu’il
faut au minimum faire intervenir des groupes de
trois nucléotides successifs (triplets), pour spécifier
les acides aminés. Des expériences de génétique
chez les bactériophages suggèrent aussi que trois
nucléotides sont suffisants pour assurer le codage ;
on appelle codons ces unités élémentaires d’information génétique.
Les expériences de déchiffrage de ce dernier
débutent en 1961 ; elles utilisent les systèmes de
traduction in vitro et des ARNm artificiels, qu’une
technologie enzymatique permet de synthétiser. Le
premier codon identifié est celui spécifiant la phénylalanine, qui est polymérisée en polypeptide, si
l’on utilise une matrice d’ARN constituée uniquement de U (poly U). Le principe des matrices artificielles monotones (poly A, poly C…), puis des
copolymères aléatoires (poly A, C, par exemple),
qui peuvent contenir huit triplets différents,
conduit à l’identification d’un nombre croissant de
codons. Une nouvelle approche, qui ne peut être
décrite ici, basée sur l’utilisation de simples trinucléotides, et ne nécessitant pas la synthèse complète d’un polypeptide, a permis en très peu de
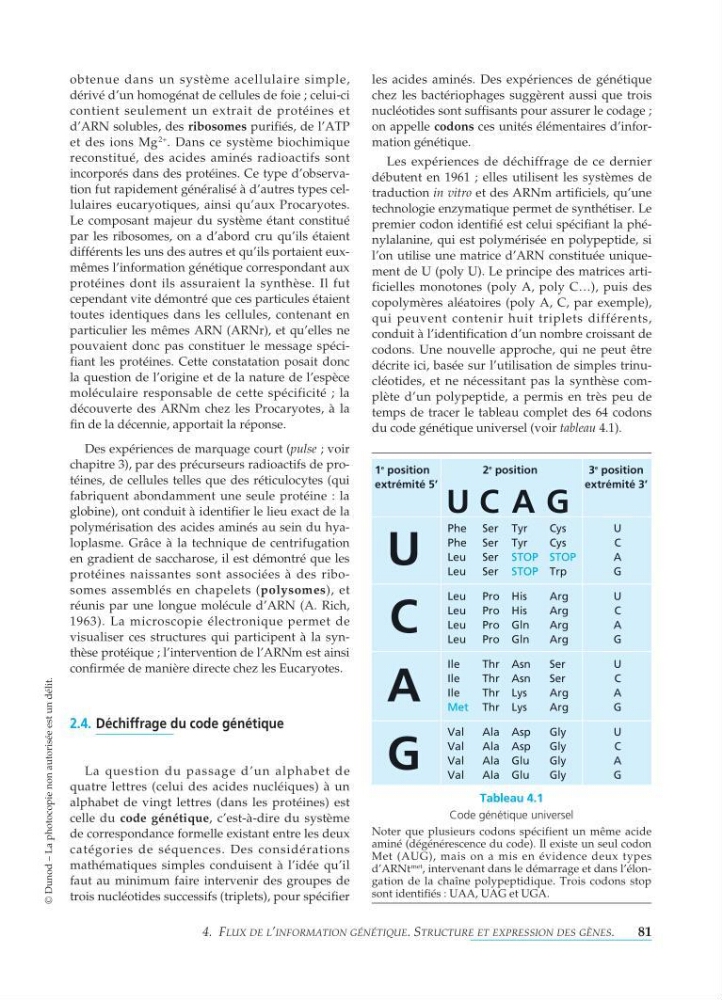
temps de tracer le tableau complet des 64 codons
du code génétique universel (voir tableau 4.1).
Tableau 4.1
Code génétique universel
Noter que plusieurs codons spécifient un même acide
aminé (dégénérescence du code). Il existe un seul codon
Met (AUG), mais on a mis en évidence deux types
d’ARNt
met
, intervenant dans le démarrage et dans l’élongation de la chaîne polypeptidique. Trois codons stop
sont identifiés : UAA, UAG et UGA.
1
e
position
2
e
position
3
e
position
extrémité 5’
extrémité 3’
Phe Ser Tyr
Cys
U
Phe Ser Tyr
Cys
C
Leu Ser STOP STOP
A
Leu Ser STOP Trp
G
Leu Pro His
Arg
U
Leu Pro His
Arg
C
Leu Pro Gln
Arg
A
Leu Pro Gln
Arg
G
Ile
Thr Asn
Ser
U
Ile
Thr Asn
Ser
C
Ile
Thr Lys
Arg
A
Met Thr Lys
Arg
G
Val
Ala Asp
Gly
U
Val
Ala Asp
Gly
C
Val
Ala Glu
Gly
A
Val
Ala Glu
Gly
G
U
C
A
G
UC AG