

4. F LUX DE L ’ INFORMATION GÉNÉTIQUE.S TRUCTURE ET EXPRESSION DES G È NES.
79
© Dunod – La photocopie non autorisée est un délit.
geables entre chromosomes homologues), indépendantes les unes des autres. Un gène a une structure
linéaire que l’on peut représenter par une carte
précise de sites mutationnels, dont l’ordre et la
distance sont fixés.
En parallèle, les progrès de la biochimie conduisent en 1953 à la démonstration que les protéines
sont des molécules linéaires non ramifiées, dont le
nombre et la séquence des acides aminés constitutifs sont également définis (séquençage de l’insuline, par S ANGER). Cette découverte révolutionne
les idées que l’on avait jusque-là sur la structure
de ces macromolécules, mais surtout elle permet
d’établir une corrélation entre deux structures
linéaires fonctionnellement liées. Le concept de
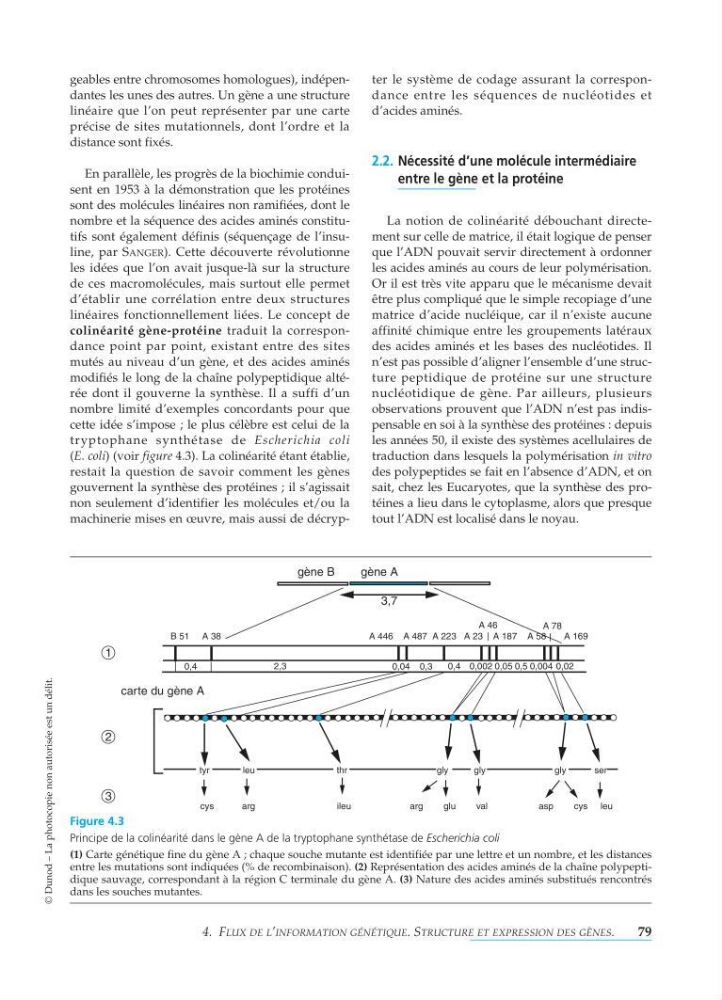
colinéarité gène-protéine traduit la correspondance point par point, existant entre des sites
mutés au niveau d’un gène, et des acides aminés
modifiés le long de la chaîne polypeptidique altérée dont il gouverne la synthèse. Il a suffi d’un
nombre limité d’exemples concordants pour que
cette idée s’impose ; le plus célèbre est celui de la
tryptophane synthétase de Escherichia coli
( E. coli)(voir figure 4.3). La colinéarité étant établie,
restait la question de savoir comment les gènes
gouvernent la synthèse des protéines ; il s’agissait
non seulement d’identifier les molécules et/ou la
machinerie mises en œuvre, mais aussi de décrypter le système de codage assurant la correspondance entre les séquences de nucléotides et
d’acides aminés.
2.2. Nécessité d’une molécule intermédiaire
entre le gène et la protéine
La notion de colinéarité débouchant directement sur celle de matrice, il était logique de penser
que l’ADN pouvait servir directement à ordonner
les acides aminés au cours de leur polymérisation.
Or il est très vite apparu que le mécanisme devait
être plus compliqué que le simple recopiage d’une
matrice d’acide nucléique, car il n’existe aucune
affinité chimique entre les groupements latéraux
des acides aminés et les bases des nucléotides. Il
n’est pas possible d’aligner l’ensemble d’une structure peptidique de protéine sur une structure
nucléotidique de gène. Par ailleurs, plusieurs
observations prouvent que l’ADN n’est pas indispensable en soi à la synthèse des protéines : depuis
les années 50, il existe des systèmes acellulaires de
traduction dans lesquels la polymérisation in vitro
des polypeptides se fait en l’absence d’ADN, et on
sait, chez les Eucaryotes, que la synthèse des protéines a lieu dans le cytoplasme, alors que presque
tout l’ADN est localisé dans le noyau.
gène B
gène A
0,4
B 51 A 38
A 446 A 487 A 223 A 23 A 187 A 58
A 169
3,7
0,04 0,3
0,002
0,4
0,05 0,5 0,004 0,02
carte du gène A
tyr
leu
thr
gly
gly
gly
ser
cys
arg
ileu
arg
glu
val
asp
cys leu
A 46
A 78
2,3
Figure 4.3
Principe de la colinéarité dans le gène A de la tryptophane synthétase de Escherichia coli
(1) Carte génétique fine du gène A;chaque souche mutante est identifiée par une lettre et un nombre, et les distances
entre les mutations sont indiquées (% de recombinaison). (2) Représentation des acides aminés de la chaîne polypeptidique sauvage, correspondant à la région C terminale du gène A. (3) Nature des acides aminés substitués rencontrés
dans les souches mutantes.
1
2
3