

Chapitre 4 • Recherche dans les banques
38
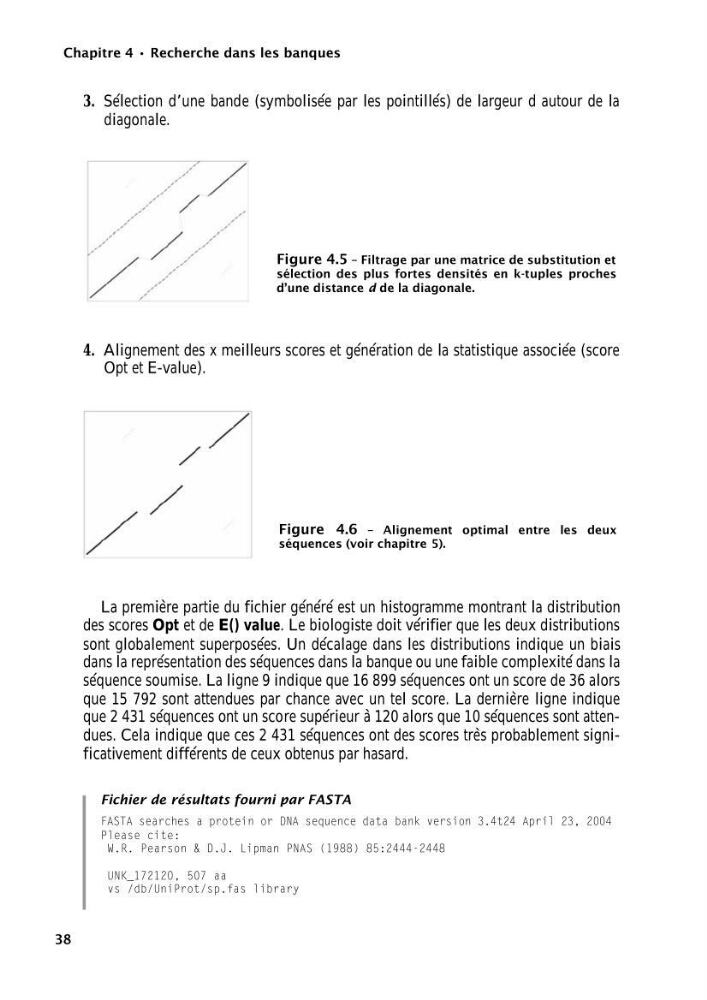
3. Sélection d’une bande (symbolisée par les pointillés) de largeur d autour de la
diagonale.
4. Alignement des x meilleurs scores et génération de la statistique associée (score
Opt et E-value).
La première partie du fichier généré est un histogramme montrant la distribution
des scores Opt et de
. Le biologiste doit vérifier que les deux distributions
E() value
sont globalement superposées. Un décalage dans les distributions indique un biais
dans la représentation des séquences dans la
complexité dans la
banque ou une faible
séquence soumise. La ligne 9 indique que 16 899 séquences ont un score de 36 alors
que 15 792 sont attendues par chance avec un tel score. La dernière ligne indique
que 2 431 séquences ont un score supérieur à 120 alors que 10 séquences sont attendues. Cela indique que ces 2 431 séquences ont des scores très probablement significativement différents de ceux obtenus par hasard.
Fichier de résultats fourni par FASTA
FASTA searches a protein or DNA sequence data bank version 3.4t24 April 23, 2004
Please cite:
W.R. Pearson & D.J. Lipman PNAS (1988) 85:2444-2448
UNK_172120, 507 aa
vs /db/UniProt/sp.fas library
Figure 4.5 – Filtrage par une matrice de substitution et
sélection des plus fortes densités en k-tuples proches
d’une distance d de la diagonale.
Figure 4.6 – Alignement optimal entre les deux
séquences (voir chapitre 5).