

© Dunod – Toute reproduction non autorisée est un délit.
131
10.5 • Méthode auto-optimisée avec alignements (SOPMA)
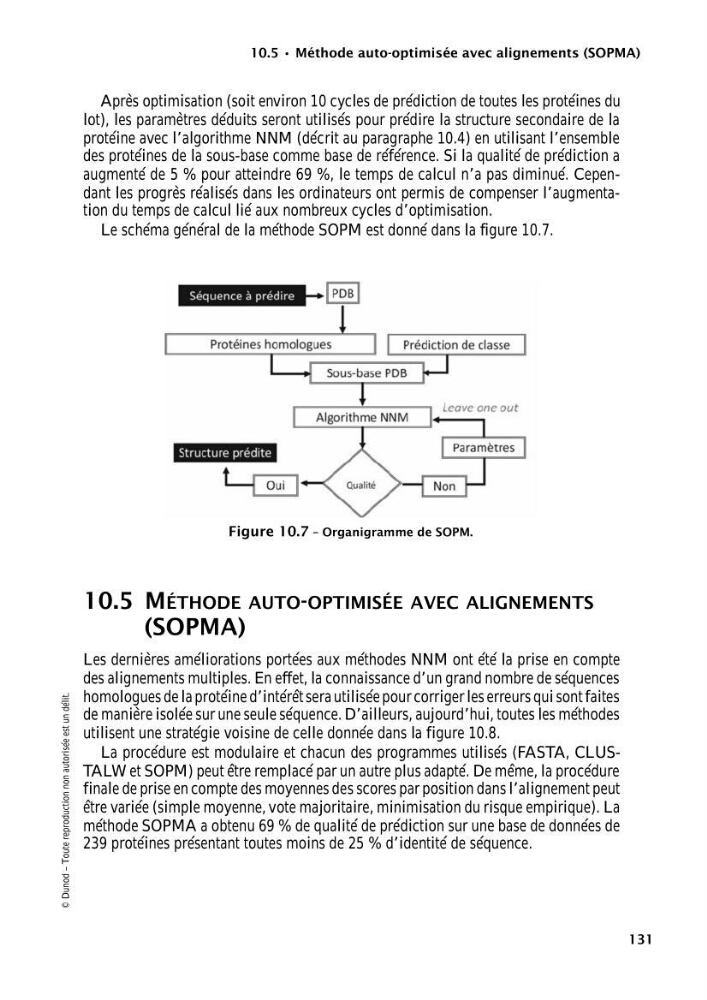
Après optimisation (soit environ 10 cycles de prédiction de toutes les protéines du
lot), les paramètres déduits seront utilisés pour prédire la structure secondaire de la
protéine avec l’algorithme NNM (décrit au paragraphe 10.4) en utilisant l’ensemble
des protéines de la sous-base comme base de référence. Si la qualité de prédiction a
augmenté de 5 % pour atteindre 69 %, le temps de calcul n’a pas diminué. Cependant les progrès réalisés dans les ordinateurs ont permis de compenser l’augmentation du temps de calcul lié aux nombreux cycles d’optimisation.
Le schéma général de la méthode SOPM est donné dans la figure 10.7.
10.5 MÉTHODE
ALIGNEMENTS
AUTO-OPTIMISÉE AVEC
(SOPMA)
Les dernières améliorations portées aux méthodes NNM ont été la prise en compte
des alignements multiples. En effet, la connaissance d’un grand nombre de séquences
homologues de la protéine d’intérêt sera utilisée pour corriger les erreurs qui sont faites
de manière isolée sur une seule séquence. D’ailleurs, aujourd’hui, toutes les méthodes
utilisent une stratégie voisine de celle donnée dans la figure 10.8.
La procédure est modulaire et chacun des programmes utilisés (FASTA, CLUSTALW et SOPM) peut être remplacé par un autre plus adapté. De même, la procédure
finale de prise en compte des moyennes des scores par position dans l’alignement peut
être variée (simple moyenne, vote majoritaire, minimisation du risque empirique). La
méthode SOPMA a obtenu 69 % de qualité de prédiction sur une base de données de
239 protéines présentant toutes moins de 25 % d’identité de séquence.
Figure 10.7 – Organigramme de SOPM.