

Chapitre 10 • Prédictions de structures secondaires
130
est de 13 à 17 résidus et le seuil de similitude a été optimisé. La qualité de prédiction
est de 67,7 % pour une séquence et de 72,8 % en combinant la méthode avec l’alignement multiple (voir paragraphe 10.6 pour le principe général).
10.4 M
(SOPM)
ÉTHODE AUTO-OPTIMISÉE
Une évolution de cette méthode NNM a consisté dans l’auto-optimisation des paramètres
prédictifs sur des sous-bases de protéines homologues et de même classe structurale.
Cela a conduit à la méthode SOPM (Self-Optimised Prediction Method). L’idée principale
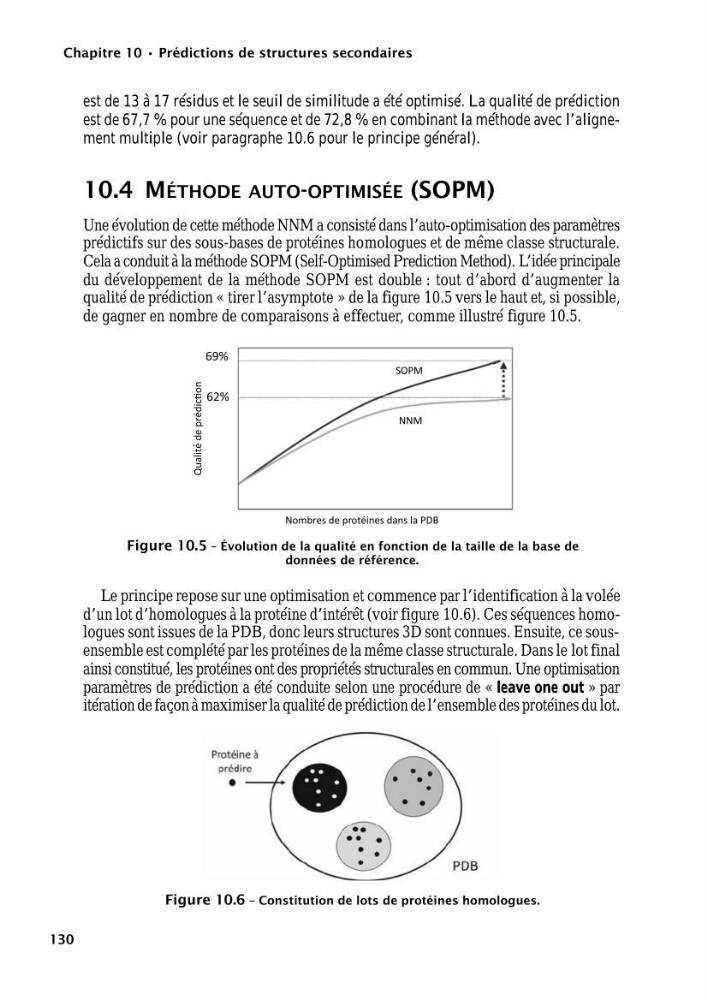
du développement de la méthode SOPM est double : tout d’abord d’augmenter la
qualité de prédiction « tirer l’asymptote » de la figure 10.5 vers le haut et, si possible,
de gagner en nombre de comparaisons à effectuer, comme illustré figure 10.5.
Le principe repose sur une optimisation et commence par l’identification à la volée
d’un lot d’homologues à la protéine d’intérêt (voir figure 10.6). Ces séquences homologues sont issues de la PDB, donc leurs structures 3D sont connues. Ensuite, ce sousensemble est complété par les protéines de la même classe structurale. Dans le lot final
ainsi constitué, les protéines ont des propriétés structurales en commun. Une optimisation
paramètres de prédiction a été conduite selon une procédure de « leave one out » par
itération de façon à maximiser la qualité de prédiction de l’ensemble des protéines du lot.
Nombres de protéines dans la PDB
Qualité de prédicƟon
69%
62%
NNM
SOPM
Figure 10.5 – Évolution de la qualité en fonction de la taille de la base de
données de référence.
Figure 10.6 – Constitution de lots de protéines homologues.