

Chapitre 7 • Algorithmes pour la phylogénie moléculaire
90
7.3.1 Modèle probabiliste utilisé au maximum de vraisemblance
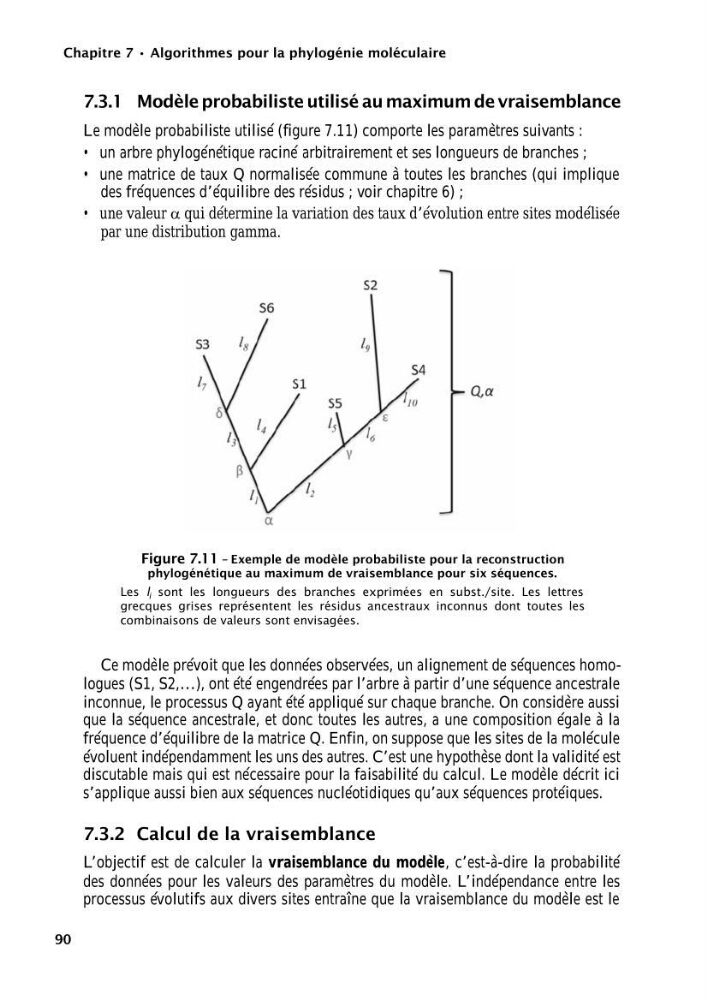
Le modèle probabiliste utilisé (figure 7.11) comporte les paramètres suivants :
• un arbre phylogénétique raciné arbitrairement et ses longueurs de branches ;
• une matrice de taux Q normalisée commune à toutes les branches (qui implique
des fréquences d’équilibre des résidus ; voir chapitre 6) ;
• une valeur
ux d’évolution entre sites modélisée
qui détermine la variation des ta
par une distribution gamma.
Ce modèle prévoit que les données observées, un alignement de séquences homologues (S1, S2,…), ont été engendrées par l’arbre à partir d’une séquence ancestrale
inconnue, le processus Q ayant été appliqué sur chaque branche. On considère aussi
que la séquence ancestrale, et donc toutes les autres, a une composition égale à la
fréquence d’équilibre de la matrice Q. Enfin, on suppose que les sites de la molécule
évoluent indépendamment les uns des autres. C’est une hypothèse dont la validité est
discutable mais qui est nécessaire pour la faisabilité du calcul. Le modèle décrit ici
s’applique aussi bien aux séquences nucléotidiques qu’aux séquences protéiques.
7.3.2 Calcul de la vraisemblance
L’objectif est de calculer la vraisemblance du modèle, c’est-à-dire la probabilité
des données pour les valeurs des paramètres du modèle. L’indépendance entre les
processus évolutifs aux divers sites entraîne que la vraisemblance du modèle est le
Figure 7.11 – Exemple de modèle probabiliste pour la reconstruction
phylogénétique au maximum de vraisemblance pour six séquences.
Les l i sont les longueurs des branches exprimées en subst./site. Les lettres
grecques grises représentent les résidus ancestraux inconnus dont toutes les
combinaisons de valeurs sont envisagées.