

Partie I
Chapitre III : Méthodes de traitement des données de télédétection
50
de bande spectrale) (hr), qui représente la différence spectrale entre les classes dans le domaine
spectral.
La segmentation est basée sur le regroupement des pixels qui sont plus proches de hs dans
le domaine spatial et hr dans le domaine spectral et sur la connexion, en tant que même région,
des points de convergence correspondants (Ming et al., 2012).
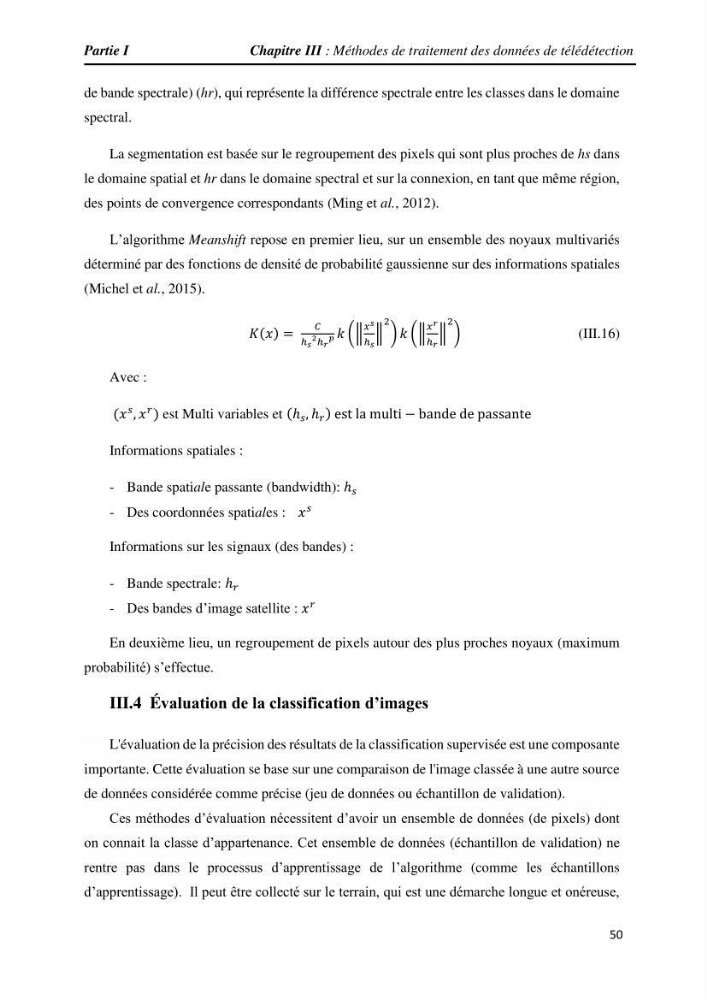
L’algorithme Meanshift repose en premier lieu, sur un ensemble des noyaux multivariés
déterminé par des fonctions de densité de probabilité gaussienne sur des informations spatiales
(Michel et al., 2015).
í µí°¾(í µí±¥) =
í µí°
ℎ í µí±
2 ℎ í µí±
í µí± í µí± (‖
í µí±¥ í µí±
ℎ í µí±
‖
2
) í µí± (‖
í µí±¥ í µí±
ℎ í µí±
‖
2
)
(III.16)
Avec :
(í µí±¥
í µí± , í µí±¥
í µí± ) est Multi variables et (ℎ í µí± , ℎ í µí± ) est la multi − bande de passante
Informations spatiales :
- Bande spatiale passante (bandwidth): ℎ í µí±
- Des coordonnées spatiales : í µí±¥
í µí±
Informations sur les signaux (des bandes) :
- Bande spectrale: ℎ í µí±
- Des bandes d’image satellite : í µí±¥
í µí±
En deuxième lieu, un regroupement de pixels autour des plus proches noyaux (maximum
probabilité) s’effectue.
III.4 Évaluation de la classification d’images
L'évaluation de la précision des résultats de la classification supervisée est une composante
importante. Cette évaluation se base sur une comparaison de l'image classée à une autre source
de données considérée comme précise (jeu de données ou échantillon de validation).
Ces méthodes d’évaluation nécessitent d’avoir un ensemble de données (de pixels) dont
on connait la classe d’appartenance. Cet ensemble de données (échantillon de validation) ne
rentre pas dans le processus d’apprentissage de l’algorithme (comme les échantillons
d’apprentissage). Il peut être collecté sur le terrain, qui est une démarche longue et onéreuse,