

Partie I
Chapitre III : Méthodes de traitement des données de télédétection
45
III.2.2.2 Random Forest
Le Random Forest (RF) ou Forets Aléatoires par Breiman (2001) a été largement utilisé
dans le domaine de la télédétection. Cet algorithme non-paramétrique est basé sur le principe
d’arbres de décision qui est un ensemble des classificateurs í µí°» = {í µí°» 1 , í µí°» 2 , … í µí°» í µí± } construits à
partir des sous-échantillons aléatoires í µí°¸ = {í µí°¸ 1 , í µí°¸ 2 , … í µí°¸ í µí± }
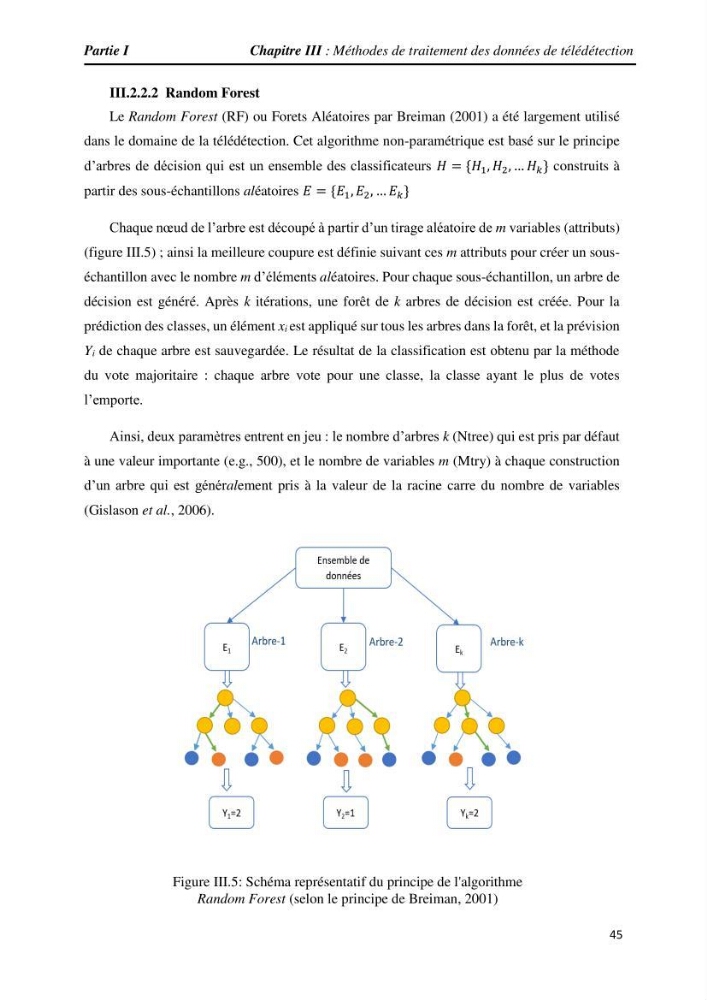
Chaque nœud de l’arbre est découpé à partir d’un tirage aléatoire de m variables (attributs)
(figure III.5) ; ainsi la meilleure coupure est définie suivant ces m attributs pour créer un souséchantillon avec le nombre m d’éléments aléatoires. Pour chaque sous-échantillon, un arbre de
décision est généré. Après k itérations, une forêt de k arbres de décision est créée. Pour la
prédiction des classes, un élément xi est appliqué sur tous les arbres dans la forêt, et la prévision
Yi de chaque arbre est sauvegardée. Le résultat de la classification est obtenu par la méthode
du vote majoritaire : chaque arbre vote pour une classe, la classe ayant le plus de votes
l’emporte.
Ainsi, deux paramètres entrent en jeu : le nombre d’arbres k (Ntree) qui est pris par défaut
à une valeur importante (e.g., 500), et le nombre de variables m (Mtry) à chaque construction
d’un arbre qui est généralement pris à la valeur de la racine carre du nombre de variables
(Gislason et al., 2006).
Figure III.5: Schéma représentatif du principe de l'algorithme
Random Forest (selon le principe de Breiman, 2001)