

90
Partie II : Matériels et méthodes
Chapitre V : Extraction automatique du trait de côte
V.4.2.1 Extraction des statistiques
Pour chaque objet résultant de la segmentation finale des images, des statistiques relatives
aux propriétés spectrales et spatiales ont été calculées, il s’agit de la moyenne, l’écart type, le
maximum et le minimum. Ces statistiques serviront l’étape d’entrainement de l’algorithme de
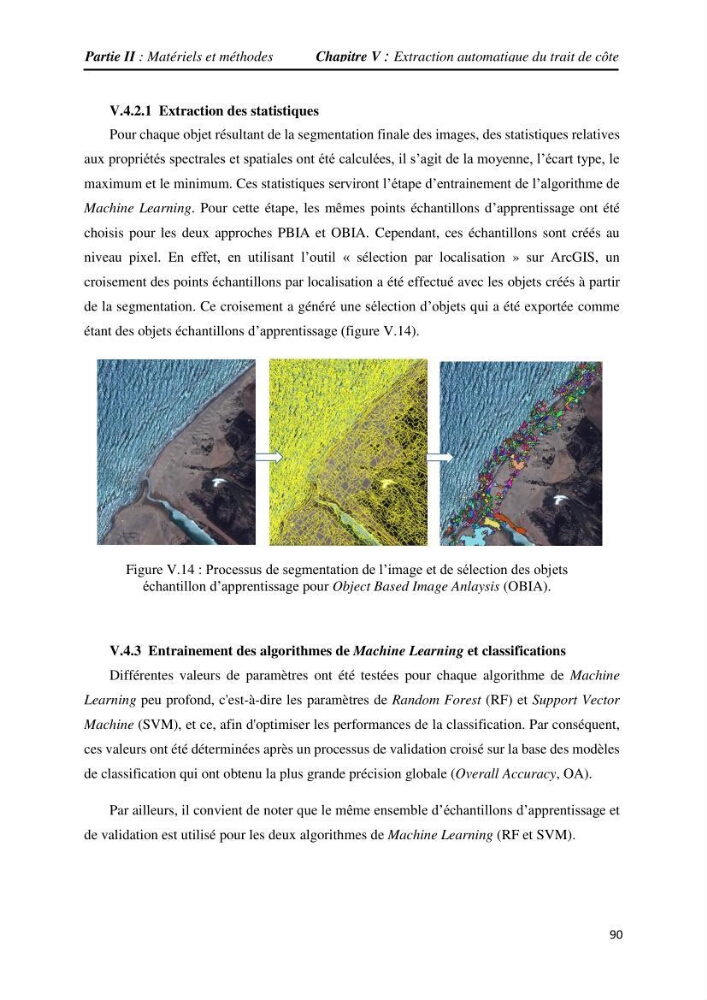
Machine Learning. Pour cette étape, les mêmes points échantillons d’apprentissage ont été
choisis pour les deux approches PBIA et OBIA. Cependant, ces échantillons sont créés au
niveau pixel. En effet, en utilisant l’outil « sélection par localisation » sur ArcGIS, un
croisement des points échantillons par localisation a été effectué avec les objets créés à partir
de la segmentation. Ce croisement a généré une sélection d’objets qui a été exportée comme
étant des objets échantillons d’apprentissage (figure V.14).
V.4.3 Entrainement des algorithmes de Machine Learning et classifications
Différentes valeurs de paramètres ont été testées pour chaque algorithme de Machine
Learning peu profond, c'est-à-dire les paramètres de Random Forest (RF) et Support Vector
Machine (SVM), et ce, afin d'optimiser les performances de la classification. Par conséquent,
ces valeurs ont été déterminées après un processus de validation croisé sur la base des modèles
de classification qui ont obtenu la plus grande précision globale (Overall Accuracy, OA).
Par ailleurs, il convient de noter que le même ensemble d’échantillons d’apprentissage et
de validation est utilisé pour les deux algorithmes de Machine Learning (RF et SVM).
Figure V.14 : Processus de segmentation de l’image et de sélection des objets
échantillon d’apprentissage pour Object Based Image Anlaysis (OBIA).