

86
Partie II : Matériels et méthodes
Chapitre V : Extraction automatique du trait de côte
V.3.2 Création des échantillons
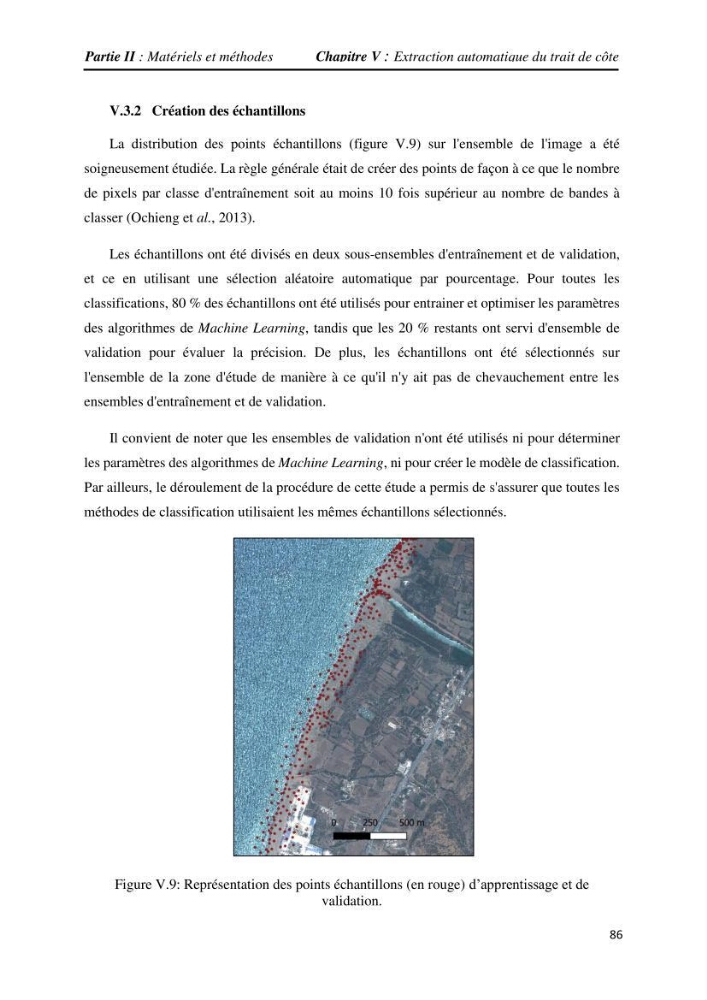
La distribution des points échantillons (figure V.9) sur l'ensemble de l'image a été
soigneusement étudiée. La règle générale était de créer des points de façon à ce que le nombre
de pixels par classe d'entraînement soit au moins 10 fois supérieur au nombre de bandes à
classer (Ochieng et al., 2013).
Les échantillons ont été divisés en deux sous-ensembles d'entraînement et de validation,
et ce en utilisant une sélection aléatoire automatique par pourcentage. Pour toutes les
classifications, 80 % des échantillons ont été utilisés pour entrainer et optimiser les paramètres
des algorithmes de Machine Learning, tandis que les 20 % restants ont servi d'ensemble de
validation pour évaluer la précision. De plus, les échantillons ont été sélectionnés sur
l'ensemble de la zone d'étude de manière à ce qu'il n'y ait pas de chevauchement entre les
ensembles d'entraînement et de validation.
Il convient de noter que les ensembles de validation n'ont été utilisés ni pour déterminer
les paramètres des algorithmes de Machine Learning, ni pour créer le modèle de classification.
Par ailleurs, le déroulement de la procédure de cette étude a permis de s'assurer que toutes les
méthodes de classification utilisaient les mêmes échantillons sélectionnés.
Figure V.9: Représentation des points échantillons (en rouge) d’apprentissage et de
validation.