

268
Chapitre 8. Optimisation du code SQL
valeurs ou les calculs qui nous intéressent à l’aide d’une fonction. En reprenant notre
exemple du compte de noms de famille, essayons de modulariser le code, pour réutiliser ce calcul dans toutes circonstances. Nous créons alors la fonction suivante :
CREATE FUNCTION Person.GetCountContacts (@LastName nvarchar(50))
RETURNS int
AS BEGIN
RETURN (SELECT COUNT(*)
FROM Person.contact
WHERE LastName LIKE @LastName)
END;
Nous profitions ainsi d’une fonction qui retourne le compte des contacts pour
toute la table (paramètre '%'), par début de nom (paramètre 'A%' par exemple, ou
par nom (paramètre 'Ackerman' par exemple) :
SELECT Person.GetCountContacts('%');
SELECT Person.GetCountContacts('A%');
SELECT Person.GetCountContacts('Ackerman');
Pratique, non ? Peut-être dans ce contexte-là, mais gardons-nous d’inclure cette
fonction dans la clause SELECT d’une requête. Observons les différences de performances entre deux façons différentes d’obtenir les mêmes résultats :
-- SELECT avec utilisation de la fonction
SELECT
t.FirstName,
t.LastName,
Person.GetCountContacts(t.LastName) as cnt
FROM Person.Contact t
GO
-- SELECT avec sous-requête
SELECT
t.FirstName,
t.LastName,
(SELECT COUNT(*)
FROM Person.Contact
WHERE LastName = t.LastName) cnt
FROM Person.Contact t
GO
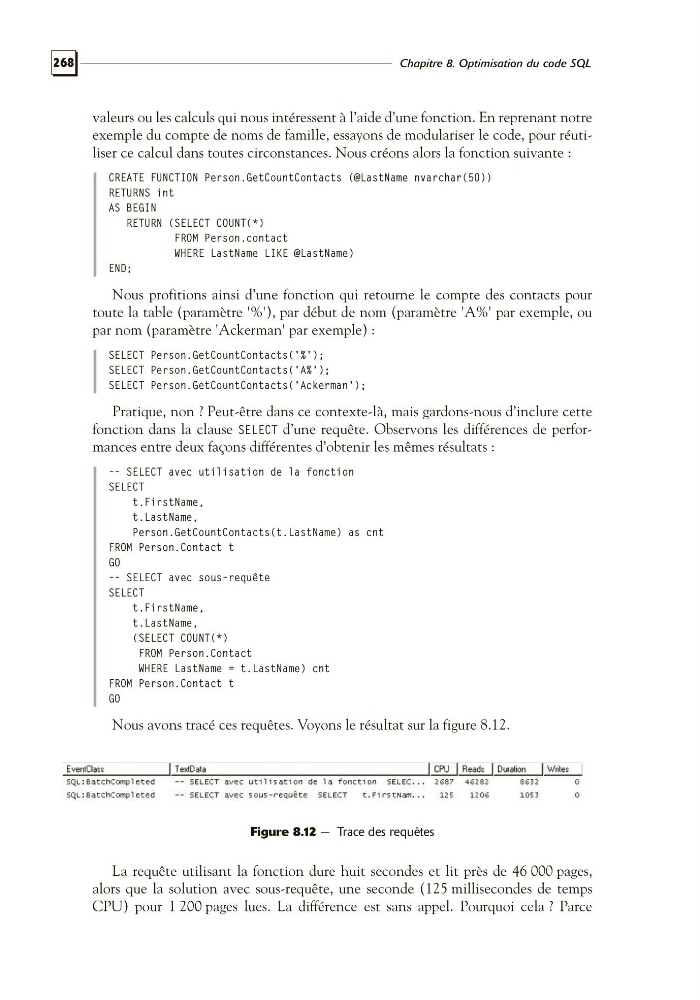
Nous avons tracé ces requêtes. Voyons le résultat sur la figure 8.12.
Figure 8.12 — Trace des requêtes
La requête utilisant la fonction dure huit secondes et lit près de 46 000 pages,
alors que la solution avec sous-requête, une seconde (125 millisecondes de temps
CPU) pour 1 200 pages lues. La différence est sans appel. Pourquoi cela ? Parce