

267
8.3 Optimisation du code SQL
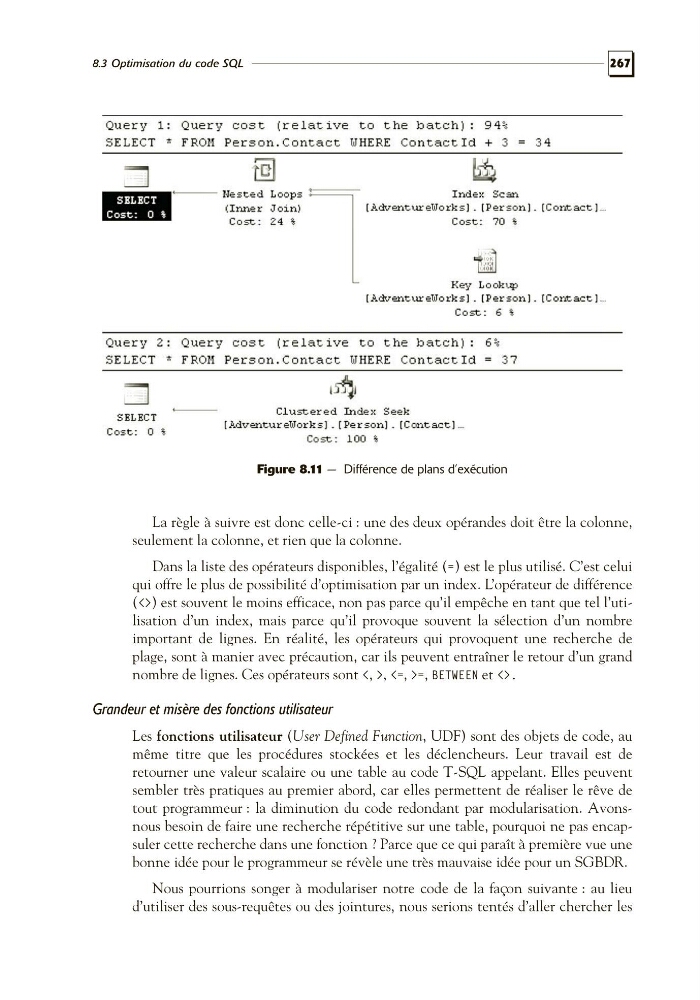
Figure 8.11 — Différence de plans d’exécution
La règle à suivre est donc celle-ci : une des deux opérandes doit être la colonne,
seulement la colonne, et rien que la colonne.
Dans la liste des opérateurs disponibles, l’égalité (=) est le plus utilisé. C’est celui
qui offre le plus de possibilité d’optimisation par un index. L’opérateur de différence
(<>) est souvent le moins efficace, non pas parce qu’il empêche en tant que tel l’utilisation d’un index, mais parce qu’il provoque souvent la sélection d’un nombre
important de lignes. En réalité, les opérateurs qui provoquent une recherche de
plage, sont à manier avec précaution, car ils peuvent entraîner le retour d’un grand
nombre de lignes. Ces opérateurs sont <, >, <=, >=, BETWEEN et <>.
Grandeur et misère des fonctions utilisateur
Les fonctions utilisateur (User Defined Function, UDF) sont des objets de code, au
même titre que les procédures stockées et les déclencheurs. Leur travail est de
retourner une valeur scalaire ou une table au code T-SQL appelant. Elles peuvent
sembler très pratiques au premier abord, car elles permettent de réaliser le rêve de
tout programmeur : la diminution du code redondant par modularisation. Avonsnous besoin de faire une recherche répétitive sur une table, pourquoi ne pas encapsuler cette recherche dans une fonction ? Parce que ce qui paraît à première vue une
bonne idée pour le programmeur se révèle une très mauvaise idée pour un SGBDR.
Nous pourrions songer à modulariser notre code de la façon suivante : au lieu
d’utiliser des sous-requêtes ou des jointures, nous serions tentés d’aller chercher les